新闻资讯
更多


AI 日报 11.03:科研应用与开源新进展
MIT 抗生素研究获奖、Claude 辅助应急报告,还有视频重生成与 3D 编程模型。6 条动态,一次看完。
AI 周报
回顾一周 AI 动态,梳理重点趋势与精选内容。
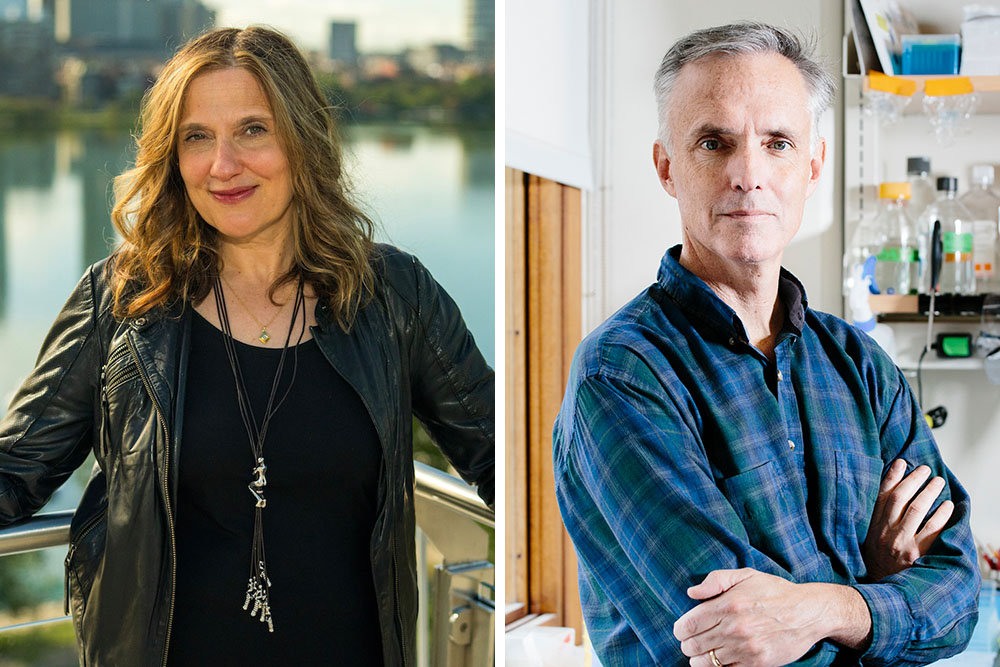
待更新两位 MIT 学者因 AI 抗生素研究获奖
MIT 报道,Regina Barzilay 与 James Collins 因利用人工智能推动抗生素发现的研究获得 Pritzker AI for Science 奖项。两人的工作把机器学习与实验生物学结合,用于寻找可能具有抗菌活性的化合物。
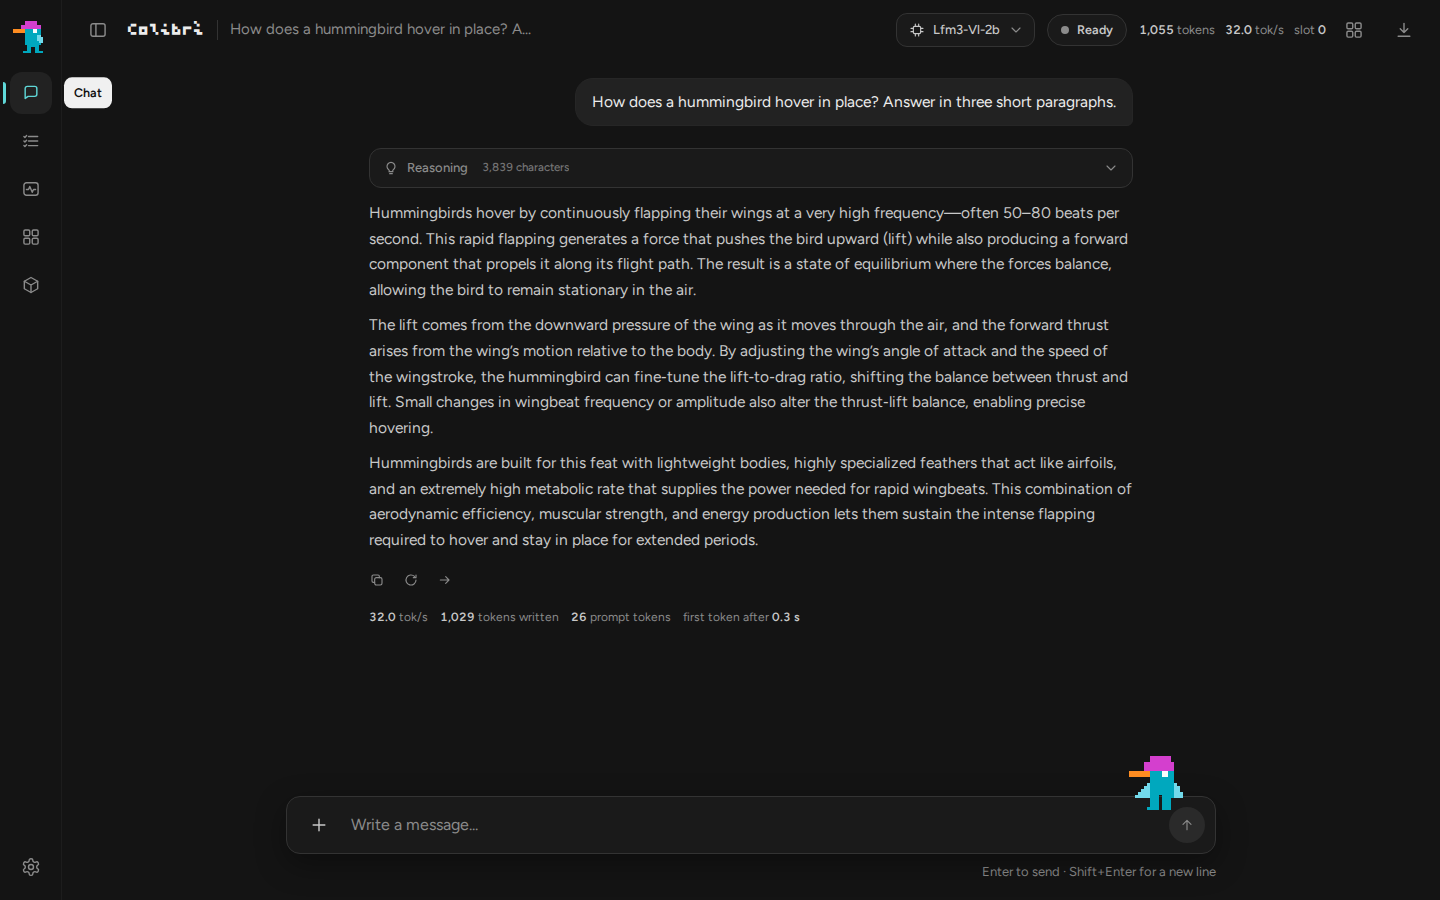
colibri 从磁盘按需加载 MoE 模型专家
开源项目 colibri 尝试让大型 MoE 模型在内存较小的电脑上运行。它把当前推理需要的部分留在内存,其余专家权重按需从磁盘读取,核心引擎使用 C 编写,并提供 CPU 及多种 GPU 路径。
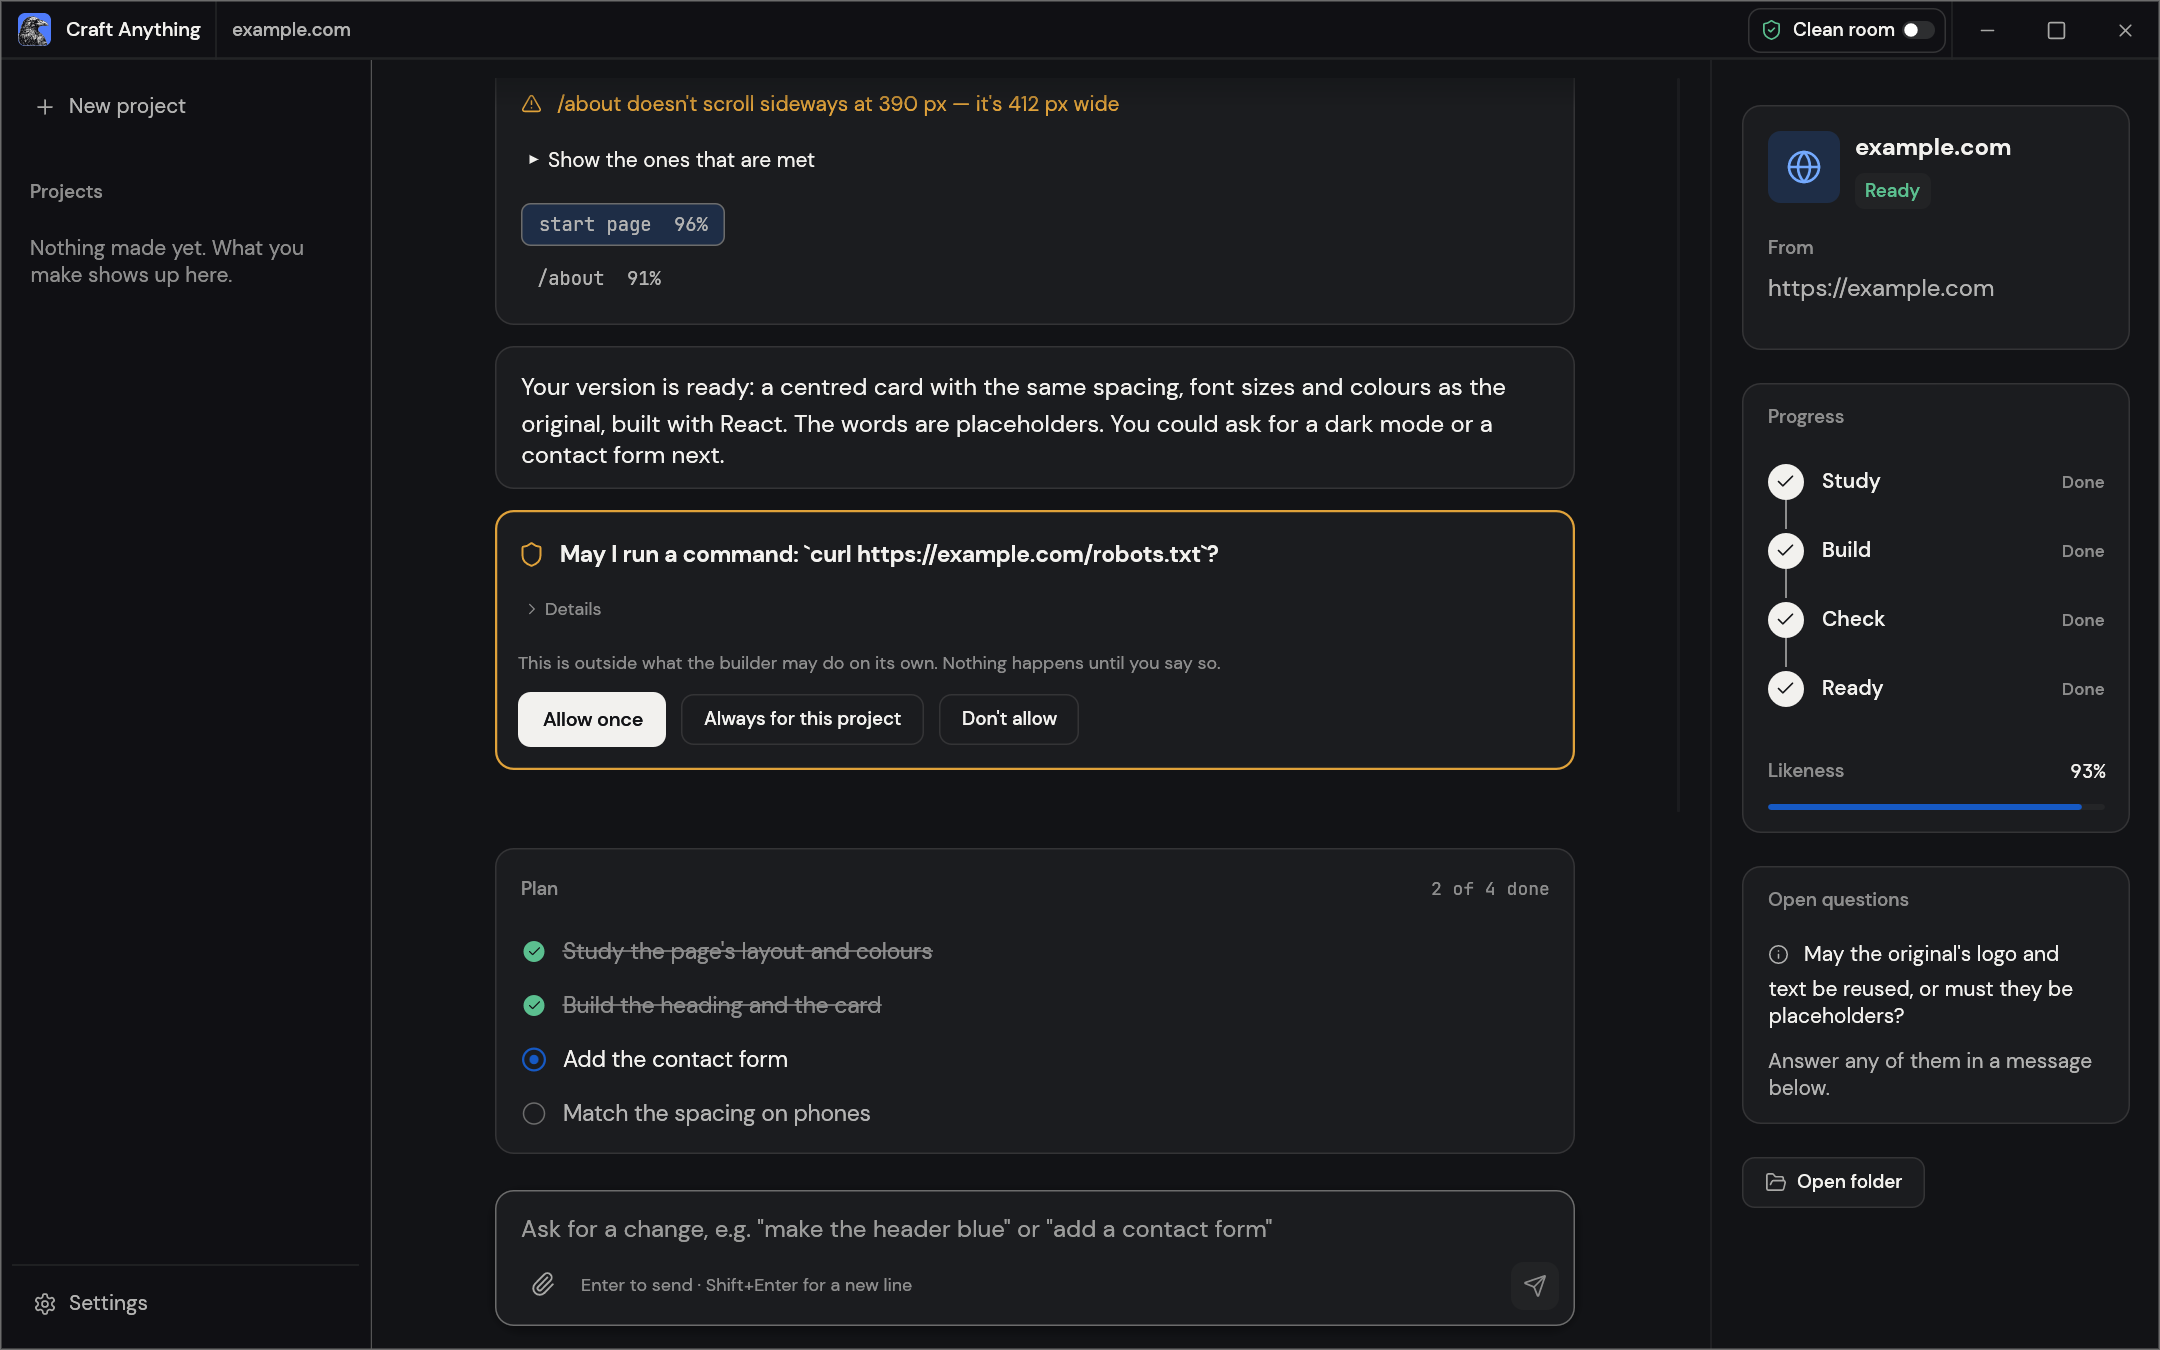
Craft Anything 把软件观察与独立实现串起来
Craft Anything 是一个用 Rust 编写的开源实验项目,尝试把观察软件行为、创建自己的实现、检查差异和继续修改连接为一个流程。它可以把编程工作交给用户配置的智能体。
Palantir 美国商业收入首超政府业务

Palantir 在 11 月 2 日披露的第三季度业绩中表示,美国商业收入首次超过美国政府业务收入。商业收入为 9.84 亿美元,同比增长 148%;政府收入为 9.53 亿美元,同比增长 96%。
Marvell 拟以 1150 亿美元收购 Lumentum

Marvell 与 Lumentum 于 11 月 2 日宣布全股票收购协议,隐含企业价值约 1150 亿美元。每股 Lumentum 股票将换取 4.5 股 Marvell 股票。
DSH Go 把智能体工作界面带到手机上
DSH Go 是基于 DeepSeek Harness 的第三方项目,提供手机聊天界面、本机引擎环境与远程主机连接。手机可以运行执行引擎,但模型请求仍交由用户配置的服务处理。
FreeToken 协调个人设备资源运行大型 MoE
FreeToken 是面向个人硬件的 MoE 推理引擎,尝试把 GPU、CPU、主机内存和设备互联作为一个可组合的平台,运行较大的开放权重模型。
Apple 智能国行版 11 月 4 日开放测试

苹果中国10月31日宣布,Apple 智能首批功能将于11月4日随 iOS 开发者 Beta 版开放测试,计划在12月随 iOS 27.3 正式推出。
Claude Code 游戏开发模板开源
GitHub 项目 Claude Code Game Studios 提供了一套游戏开发配置,将策划、任务拆分、代码实现和检查等职责放进 Claude Code 的项目环境。
Claude Ultra 已验证账号取消五小时限制

Claude 官方帮助中心更新了 Ultra 套餐说明:通过验证的账号不再受到五小时使用限制,可以在每周额度内连续使用。网页订阅价格为每月200美元。
Lightpanda:面向 AI 采集的轻量浏览器
Lightpanda 是一款面向网页采集和 AI 自动化的无头浏览器。项目使用 Zig 开发,采用独立引擎,支持执行 JavaScript、读取网页内容,并通过 CDP 接口连接自动化工具。
Claude Code 开发往事:两天做出原型

Anthropic 在《The making of Claude Code》中披露了这款编程工具的早期开发过程。团队访谈显示,Boris Cherny 于2024年9月加入 Labs 后,用两天时间制作了一个终端原型,最初的演示还涉及控制音乐应用;随后,同事开始拿它处理编程任务。
Gemini 4 Carbon 发布,先向安全团队开放

Google 于 10 月 28 日公布 Gemini 4 Carbon,重点提升代码、网络安全和长时间智能体任务能力。首批访问面向部分网络防御团队,后续通过 Fairwind 计划扩大到受信任合作伙伴,尚未向所有普通用户开放。
Genie 4 开放研究预览,可实时修改世界并生成声音

Google DeepMind 于 10 月 27 日发布 Genie 4 世界模型,支持在运行中的模拟世界里用文字修改天气、场景、角色和事件,并同步生成环境音、音乐与对话。Gemini 模型参与理解指令和规划场景中的事件。
OXR 将 PDF 转成 AI 可读的结构化数据
SoMark 团队公开 OXR 文档解析模型及代码,将 PDF 和文档图片转换为 Markdown 或 JSON,同时保留版面坐标,方便智能体检索和处理。模型规模为 13 亿参数,支持文字、表格、公式等多种文档元素。
DeepSeek 社区量化版公布逐档评测

AtomicChat 在 Hugging Face 发布基于 DeepSeek-V4.1-Flash-1017 的社区 GGUF 衍生版本,组合 GSQ-RCO 量化和行为调整,并公开各个量化档位的测试记录。这是社区维护的版本,并非 DeepSeek 官方发布。
JustGoal 让 AI 自行优化 GPU 算子

10 月 27 日发布的 JustGoal 论文测试了一种更简单的算子优化方式:只向通用智能体提供优化目标和约束,让它自己编写算子、建立评测循环并持续调整,不预设专门的算子知识库或工作流。
Trajectory 获 4500 万美元融资,推出模型训练平台

Trajectory 于 11 月 2 日宣布完成 4500 万美元 A 轮融资,估值 3 亿美元,由红杉资本领投,NVIDIA、Bessemer 和 Bain Capital Ventures 参投。同日发布的平台把模型后训练、评估与部署放进同一套工作界面。
HachimoDock 把 AI 任务进度变成桌面小宠物
HachimoDock 是一个公开资料的桌面 AI 硬件项目:小屏幕上的角色会随着智能体的思考、执行和等待状态变化,让电脑里的任务有一个看得见的实体入口。项目同时提供电脑客户端与 ESP32-P4 固件。
OBLITERATUS 发布 DeepSeek 衍生模型评测
OBLITERATUS 公布了基于 DeepSeek-V4.1-Flash-1017 的行为调整版本,提供 BF16 权重和评测方法。这一社区版本改变了模型的拒答行为,不是 DeepSeek 官方更新。
Anthropic 更新招股书:季度营收约 170 亿美元
Anthropic 在 11 月 2 日更新的 S-1/A 中披露,第三季度营收为 169.56 亿美元,第二季度为 115.55 亿美元;第三季度经营亏损 5.67 亿美元,净亏损 232.91 亿美元。净亏损包含大额可转换票据等公允价值变动,不能直接等同于现金消耗。
Oracle 拟发行股票和债券,合计融资 200 亿美元

Oracle 于 11 月 2 日提交的发行文件列出 100 亿美元普通股融资,并说明另有一笔 100 亿美元高级债券发行同步推进。两笔发行彼此不以对方完成为前提,仍以最终发行条件为准。
ADNOC 联合 OpenAI、G42 推进能源 AI 应用

阿布扎比国家石油公司 ADNOC 于 11 月 2 日宣布,与 OpenAI、G42 签署多年合作协议,将 OpenAI Frontier 引入能源业务,连接生产、加工、炼化、物流及销售环节的智能体。
OpenAI 公布 Rosalind-6 科研访问与安全说明

OpenAI 发布 GPT-Rosalind-6 系统卡补充说明,将其定位于生物学、药物发现和转化医学研究。该模型与 GPT-6 Astra 使用相同权重,通过受信任访问向符合条件的科研机构、企业及政府合作伙伴提供。
Google Research 扩展科研与地理空间 AI 工具

Google Research 在 Research@ 活动中集中展示了地理空间分析、科学研究和边缘计算方向的进展。其中,Earth AI 扩大早期访问,并整合公共数据集搜索与时间序列预测能力。
MIT 研究让机器分辨声音与环境
MIT News 在 10 月 28 日介绍了教授 Paris Smaragdis 的声音机器学习研究。他的团队关注的不只是把语音变成文字,还包括分离不同声源、理解环境声音,以及帮助创作者编辑和分析音乐。
AWM 用数学证明判断游戏目标能否实现
Algebraic World Model(AWM)研究尝试让 AI 从陌生环境中学出可检查的数学规则:先探索并编写 Python 假设,再依据观测修正规则,最终转换为 Lean 4 形式化模型,证明目标可达或不可达。
LFM3 社区 GGUF 版本公布兼容要求
AtomicChat 在 Hugging Face 发布基于 LiquidAI/LFM3-1.7B 的社区 GGUF 衍生版本,并附带行为变化和能力测试记录。它不是 Liquid AI 官方发行,仍需遵循基础模型的 LFM Open License v1.0。
Open-H3 开放高分辨率视频重生成方案
Efficient-Large-Model 团队开放 Open-H3-Regenerate-2K,把低分辨率视频草稿重新生成为高分辨率画面。项目基于 MiniMax H3,提供三步细化流程,项目页列出最高 4K 的输出路径。
4B 社区模型尝试生成 Three.js 场景
CCORE 发布 Qwen3.5-4B-3D-Coder 预览版,针对交互式 Three.js 场景和代码生成进行独立微调。项目提供 FP16、Q4_K_M 与 Q8_0 权重,还公开了包含 4146 个场景样例的训练数据集。
Claude 被用于整理埃博拉应急报告
Anthropic 在案例介绍中披露,WHO 非洲区域办事处、CEPI 与刚果(金)INRB 的团队正在尝试用 Claude 整理一线数据、研究资料与疫情应急工作记录。
Qwen-Image 社区量化包面向本地生成
社区维护者 abenzerps 发布 Qwen-Image-2.1 量化资源,提供 GGUF、Safetensors 与 MLX 等格式,用于不同硬件上的本地图片生成。模型卡列出配套文本编码器、VAE 与 ComfyUI 文件目录要求。
PostgreSQL 19 延后,维护者谈 AI 查错压力

PostgreSQL 核心贡献者 Robert Haas 在 10 月 21 日的文章中表示,AI 辅助发现缺陷的速度正在超过人工审核与修复能力,增加了 PostgreSQL 19 发布前的维护压力。项目公开计划将正式版日期放在 11 月 19 日。
JEPA 研究检验不同模型的共同表征
一篇 JEPA 研究预印本探讨:独立训练的文本与视觉模型,是否会学到可以对应的世界表征。作者给出带有明确条件的数学结果,并通过多种规模的数据实验检验表征对齐。
PixVerse 联合 OpenAI 推出创作培训

PixVerse 与 OpenAI 在 10 月 8 日公布了 Prompt to Production 教育合作,围绕创意策划、素材生成和成片制作提供演示课程。合作包括面向不同地区的两场线上研讨会,以及后续在 PixVerse 官方频道更新的视频系列。
OpenPerov 用论文证据辅助太阳能电池设计
研究团队在 arXiv 发布 OpenPerov 预印本,尝试把文献证据和专家推理结合,用于钙钛矿太阳能电池的设计与优化。团队整理了来自 4,532 篇论文的证据,并建立包含 800 道问题的 PSMBench 评测。
Agent Desktop 让 AI 读取桌面界面结构
Vercel Labs 的 Agent Desktop 提供命令行工具和 C 接口,让智能体利用操作系统的无障碍界面树识别按钮、输入框等元素,再执行相应操作。项目覆盖 macOS、Windows 和 Linux,并采用 Apache 2.0 许可证。
TopoQuant 用拓扑变化检查模型量化损失
TopoQuant 研究尝试在不反复运行昂贵下游评测的情况下,判断大模型量化后是否出现行为偏移。团队用拓扑数据分析描述参数结构变化,再观察它与注意力一致性的关系。
SenseNova Loop 用共享权重加深模型计算
商汤公开的 SenseNova-Loop-9B-Preview 支持文字和图像输入,面向长上下文、文档理解、编程及工具交互。它在解码器中重复执行一段共享权重的层,以较少的参数副本增加计算深度。
让大模型读求解日志,减少参数调优试错
LDST 研究把混合整数规划求解器的日志交给语言模型分析。系统先提取运行瓶颈,再提出少量参数修改,并在执行前校验配置,而不是把每次求解结果只当作一个黑盒分数。
AI 智能体尝试解释量子实验数据
一项预印本把语言模型智能体用于量子系统的模型发现:系统提出候选物理模型,调用计算工具,再比较不同假设对实验数据的解释能力。研究使用了三组此前公开的金刚石与碳化硅色心实验数据。
Anthropic 招募生命科学客座研究员
Anthropic 发起生命科学客座研究员征集,邀请高校、非营利机构和政府实验室的研究负责人及团队提交合作项目。方向包括人类生物学、结构与计算分子生物学、药物化学、药物发现和临床科学。
Pandora 研究更贴近个体的咨询来访者模拟
Pandora 预印本研究如何让心理咨询来访者模拟器更贴近个体的表达方式。系统会根据咨询互动更新心理与关系状态,再单独规划表达内容和语言风格,避免模拟角色总能过分清楚地解释自己的困扰。
Audio8 TTS 小模型支持 23 种语言语音生成
Audio8-TTS-Realistic-Air 基于 0.6B 级架构,支持文本转语音和零样本声音克隆。模型卡列出 23 种支持语言,并提供交互试玩入口、模型权重和 44.1kHz 音频编解码器。
机器人精细操作:更好的示范比大模型重要?
Friday 团队公开了 MetaFine 精细操作挑战赛的方案:每项任务采用约 1,900 万参数的策略模型,而不是直接微调大型视觉语言动作模型。训练数据来自模拟器中的脚本教师,也包含对学生模型错误的纠正。
Trail 把智能家居指令变成本地分层选择
Trail 研究提出一种完全本地运行的智能家居控制方式。系统不让小模型自由编造控制命令,而是从实际设备注册表中依次选择房间、设备和操作;对把握不足的请求可以拒绝执行。
研究重查正交训练:收益未必来自正交性
一项语言模型训练研究比较了 14 种正交约束方案,模型规模从 3.6 亿到 31 亿参数,训练数据接近 2,000 亿 Token。作者希望分清性能改善究竟来自正交结构,还是来自参数归一化等其他因素。
塔吉克语检索模型公开训练与评测方法
Saidzoda-Tajik-E5-Large 基于 5.6 亿参数的多语言嵌入模型微调,面向塔吉克语文档检索。研究使用法律、税务、百科和网页文本构造问答对,同时混入英语与俄语数据,以保留多语言能力。
Omen 收购 Aquatic Labs,补强数据中心液冷监测

Omen AI 于 11 月 2 日宣布,以现金和股票合计 1,600 万美元收购 Aquatic Labs。后者创始人 Allan Adams 将担任首席科学官并负责研发。
研究为注意力输出的扰动范围提供新证明
一项 Transformer 注意力研究提出锥规划框架,尝试为输入变化会让注意力输出偏移多少提供可计算的保证。论文区分了固定查询与查询、键共同变化时的难度。
PrismServe 协调不同厂商加速器运行大模型
PrismServe 研究面向混合硬件集群的大模型服务。系统在同类设备组内运行量化专家,先根据预期回答质量选择专家,再按负载与缓存位置选择具体副本,减少跨硬件协作的开销。
Matt Pocock 公开可组合的工程开发技能集
开发者 Matt Pocock 在 GitHub 公开日常使用的智能体技能集,强调用小而可修改的工作流程辅助真实工程开发。技能可以按任务组合,不要求把整个开发过程交给一套固定框架。
SFTProbe 用少量探测筛选推理训练数据
SFTProbe 研究尝试减少推理模型微调数据的筛选成本。方法先做短暂的 LoRA 适配,再只检查每条推理轨迹的一小部分,通过损失特征估计样本难度与多样性。
Worktrunk 简化多个 AI 编程任务的隔离开发
Worktrunk 是面向 Git worktree 的命令行工具,用于管理多个并行开发目录。不同智能体可以在各自的分支与工作目录中处理任务,降低相互覆盖文件的风险。
BitLLM 优化手机 GPU 上的低比特模型解码
BitLLM 研究把手机 GPU 上的低比特模型推理瓶颈拆成数值类型转换和 KV 缓存访问两部分。方案调整缓存布局,并把部分转换移出矩阵计算的关键路径。
Paperclip 用一个面板管理多个 AI 智能体
Paperclip 用 Node.js 服务和 React 界面组织多个 AI 智能体。用户可以分配目标、追踪任务与成本,并为不同角色选择模型和执行框架。
Skill++ 改写技能说明,减少智能体选错工具
Skill++ 研究关注技能库越变越大后,智能体反而选错技能的问题。新增技能的名称和描述可能挤占原有技能的匹配范围,即使旧技能本身没有修改。
nanochat 用紧凑代码串起聊天模型训练流程
Karpathy 的 nanochat 提供一套较精简的聊天模型训练实验框架,覆盖分词、预训练、微调、评测和推理。开发者可以在单个 GPU 节点上研究一整条模型制作流程。
SYN-DIGITS 校准 AI 对人类回答的模拟
SYN-DIGITS 研究尝试修正语言模型模拟人类回答时的系统偏差。方法利用参考问题上的真人数据,以及数字角色在不同问题之间表现出的关联,推测目标问题的回答。
heretic 探索无需重训的模型行为调整
heretic 是一个通过模型权重处理来研究语言模型行为变化的开源项目。它提供可配置的提示与评分流程,用于比较修改前后的行为表现,仓库也列出了支持的模型类型。
新基准检验 AI 能否看懂政策如何变化
DAPE 基准同时判断两份政策是否属于同一领域,以及后一份是延续、扩大、缩小还是逆转前一份。研究用 1,000 组中国政府政策指令构建专家标注数据,避免把困难样本简单归为不相关。
这个 Claude Code 技能用真实操作制作演示视频
skill-video-studio 把产品演示制作组织为本地工作流程:先制定演示计划,再用浏览器录制真实操作,通过 HyperFrames 编排画面,最后使用 FFmpeg 输出视频。旁白、音乐和字幕可以按需加入。
AStockArena 不只看收益,也查交易是否有据
AStockArena 为金融智能体增加决策审计:把模型报告、交易请求、实际执行回执和账户状态对齐,检查操作是否可追溯、理由是否有证据,以及模型是否正确理解账户情况。
审计场景研究:AI 也会受到同事意见影响
一项实验让语言模型扮演审计人员,先形成估计,再面对没有新增证据的上级、同事、外部审阅人或客户质疑。研究比较了 12 组模型设置。
MedForget 检查医疗模型能否有针对性地遗忘
MedForget 把医疗机构及其数据的层级关系纳入多模态遗忘评测,考察删除某一层数据影响时,模型能否保留其他相关能力。
研究用读者反应轨迹引导 AI 写故事
一项故事生成研究先从人类作品中学习读者反应随情节变化的轨迹,再让较小模型预测这些变化,指导较大的写作模型逐段生成故事。
去掉选择题选项后,医疗 AI 得分明显下降
一项研究对 14 个模型进行了医疗问答比较,测试同一道题在提供选项和不提供选项时的表现。数据涉及四套基准的 3,076 道题。
CLAS 根据上下文调整模型行为引导强度
CLAS 将模型激活引导拆成固定方向与随上下文变化的系数。相比始终施加同样力度,它可以在同一次生成的不同位置选择性地引导不同表现。
工具调用前,怎样判断 AI 是否有把握?
一项研究专门评估大模型函数调用的不确定性,而不只研究普通问答的置信度。作者比较单次与多次采样方法,检验这些分数能否区分可能错误的工具调用。
ResMem 把检索到的知识转成可复用参数记忆
ResMem 研究让模型离线阅读检索文本,再把这些证据如何改变答案分布的差异写入独立参数记忆。这样可以在后续使用中减少重复在线检索,而不是简单模仿检索器的预测。
模型改变了数据,统计置信度也要跟着改
一项统计研究关注预测系统上线后的反馈:模型影响人的决策,进而改变下一轮训练数据。早期估计误差会沿着部署和再训练过程传播。
AuthRank 用来源关系帮助识别情报投毒
AuthRank 尝试给网络威胁情报来源建立可信度评分。系统结合引用关系、主张支持情况、时间衰减和作者信息,减少大模型流水线被污染资料误导的风险。
预训练数据投毒研究揭示智能体执行风险
一项安全研究发现,攻击者在模型预训练数据中混入少量设计过的内容,可能让后续智能体在特定触发条件下执行异常指令,即使之后的训练流程使用干净数据。
FSDAM 用少量示例学习驾驶员注意力变化
FSDAM 研究将驾驶员注意力预测拆成看哪里和为什么看两个任务。系统从场景、当前关注点、预计下一关注点与原因建立结构化表示。
单个 AI 可靠,不代表组成团队后仍可靠
一项多智能体安全研究让模型群体共同判断是否升级安全告警,并加入持续主张某一结论的少数代理,观察集体决策如何偏移。
TileWeave 让手机 NPU 与 GPU 分担长上下文计算
TileWeave 研究按复用程度拆分稀疏注意力计算:共享程度高的块交给适合规则计算的 NPU,复用较低的部分交给 GPU,并协调结果合并。
视觉模型按问题选择中间层,不只看最后一层
Mixture of Layers 研究让多模态模型根据文字问题,动态选择视觉编码器的中间层表示。不同层保留的局部细节与抽象信息不同,固定只取最后几层可能遗漏小物体、文字等线索。
ATTUNE 用编程智能体调优大模型训练配置
ATTUNE 让编程智能体在限定 GPU 时间预算内寻找训练瓶颈,每次修改一个配置,并用智能体之外的正确性检查拦截可能改变训练含义的方案。
Penelope 为多轮智能体任务重新设计缓存淘汰
Penelope 研究指出,智能体经常重复使用长历史,而靠近序列末尾的 KV 缓存重算成本可能更高。它在保留共享前缀的同时,优先保存后部缓存,只重算缺失片段。
人类与模型如何在经验推断和现场推理间切换
一项研究区分了两种推断方式:把熟悉关系逐渐写入内部表示,以便快速调用;或在遇到新关系时,通过注意力在上下文中现场推理。
多层 AI 防护不能只按彼此独立来算风险
一项研究讨论多个智能体防护组件之间的依赖关系。不同审核器可能犯相似错误,简单叠加各自准确率会低估系统风险。
SHIFT 用“收缩再修复”改进模型遗忘学习
SHIFT 研究先把微调模型向微调前的权重收缩,再短暂学习需要保留的数据,据此估计删除特定数据影响的方向。方法将变化转为蒸馏目标并迭代调整。
Reasoning Consensus 把多模型推理合成支持图
Reasoning Consensus 从多个模型的推理中提取结构化步骤,合并等价节点,再按支持该步骤的推理链数量赋权。读者可以看到某个结论背后哪些环节得到更多支持。
C3 针对长语音任务优化 KV 缓存检索
C3 研究根据音频注意力的结构组织 KV 缓存:不同查询头共享检索预算,系统再动态调整检索粒度,以减少每步读取的数据量。
录音里的话和声音冲突时,AI 更相信谁?
SAC-Bench 把环境声音与一致或矛盾的口头描述放进同一段音频,检验音频语言模型是否真正根据声音作答。基准覆盖事件、时间与空间关系。
“潜在辩论”框架尝试解释模型的是非判断
一项研究用结构化的支持与反对信号近似语言模型在二元判断任务中的内部过程。作者将这种解释框架称为 latent debate,而不是让多个模型真的展开对话。
AgentKerr 让智能体参与磁性显微实验
AgentKerr 将语言模型智能体接入磁光克尔显微镜实验。卷积网络先从实时影像中提取磁性结构的位置、大小和形状,智能体再据此规划激励、成像与分析步骤。
模型会算一步,不代表能连续跟踪状态
WMIP 用程序生成答案,测试语言模型在多次更新后能否正确报告最终或中间状态。它在相同题目上比较不同输出规则,避免把题型差异混入结论。
量化研究用低秩与稀疏补偿保留模型信息
一项模型压缩研究把权重拆为量化矩阵、低秩部分和处理离群行的稀疏部分,尝试用少量额外存储补偿低比特转换损失。
方言进入生成式 AI,标准语言之外还有哪些难题
一篇跨学科研究以南蒂罗尔方言和库尔德语变体为例,讨论生成式 AI 如何处理非标准化语言。作者结合社会语言学与计算语言学视角,分析数据、技术与语言规范之间的关系。
BRACE 同时检查医学陈述、报告与引用证据
BRACE 研究为医学陈述核验构造训练样本,不只替换引用,还同时考察患者报告是否支持模型说法。系统利用公开放射报告和相关医学条目生成对照例子。
AI 生成的调查样本,不能只用一个准确率判断
一项社会科学方法研究用欧洲晴雨表中的 AI 态度数据,比较模型合成调查样本的个体预测、总体分布和变量关系。
Taurus 将 CT 标注从自由生成改为重点复核
Taurus 研究比较语言模型自由编写分割程序,以及先自动标注再由模型审核两种方式。团队使用六个公开主动脉 CT 数据集进行盲标注恢复评测。
研究回顾:BPE 分词为什么能压缩文本
一篇关于 BPE 的理论研究分析了分词背后的压缩问题。作者证明,寻找最优的成对编码属于 APX 完全问题,同时给出 BPE 在所有输入上都成立的最坏情形近似保证。
RE-SciVQA 用检索和小模型读懂论文图表
RE-SciVQA 将论文的章节标题、图表引用和图注纳入检索,再用 LoRA 微调较小的语言模型回答科学图表问题。它没有另建复杂的大型模型,而是先改善模型读到的上下文。
先制造错误,再检验 AI 修复图数据的能力
一项图数据研究提出更系统的修复评测方法:从符合规则的图开始,按形式化规则引入错误,再检查修复系统能否恢复约束。这样可以知道测试覆盖了哪些错误,而不只依赖临时收集的坏数据。
AI 能预测材料性质,化学键仍然有用
一项材料研究讨论了深度学习是否会取代化学键概念。作者通过线性探针发现,Allegro 和 MACE 的内部表示仍能恢复化学键相关描述,说明模型可能以自己的方式学到了这类信息。
TokenEconomizer 帮编程智能体减少重复消耗
TokenEconomizer 是编程智能体外部的成本控制器。它从连续任务中积累经验,选择注入哪些操作技巧、移除长期无用的工具,并在失败循环中介入,避免每个任务都重新试错。
TradingAgents:把多角色讨论引入交易研究
TradingAgents 用多智能体模拟交易团队的分工,包括基本面、情绪、技术分析、风险管理及交易决策。看多和看空角色分别提出理由,再由其他角色综合信息。
Harness² 让智能体逐步改进自己的执行框架
Harness² 将智能体改进分成两层:当前任务中提出、测试并组合执行框架的修改;跨任务再提取这些修改的经验,帮助处理之后遇到的新场景。
Unlimited OCR 尝试用固定缓存处理长文档
Unlimited OCR 针对长文档识别中缓存不断增长的问题,引入参考滑动窗口注意力 R-SWA。解码时保留所需参考信息,让 KV 缓存保持恒定,而不是随输出文本持续扩张。
HairDeck 从一张图生成可做动画的发型
HairDeck 面向游戏和虚拟角色的风格化头发,将发片视为一组无序的几何单元,通过集合扩散模型一起生成,而不是逐个预测很长的控制点序列。
Edge0 从 SSD 调入专家,降低模型内存占用
Edge0 为消费级设备运行混合专家模型设计了预路由机制:提前预测下一层需要的专家权重,再从 SSD 加载,尽量让读盘与计算重叠。团队还训练了恢复适配器,缓解量化和路由替换带来的质量损失。
AgentScope 把工具调用、评测和运行环境接起来
AgentScope 1.0 的论文介绍了面向开发者的智能体应用框架:统一模型和工具接口,以异步设计支持人与智能体、智能体之间的交互,并将 ReAct 工作方式作为基础。
研究回顾:vLLM 如何减少推理缓存浪费
PagedAttention 借鉴操作系统的虚拟内存分页方式,管理推理请求不断增长的 KV 缓存,减少碎片和重复副本,并允许请求之间共享适当的数据。vLLM 建立在这类机制之上。
MOSS-Image 瞄准长文字与复杂版式生成
MOSS-Image 技术报告提出一套面向图文密集场景的生成系统。团队从头训练 5B 扩散 Transformer,并用意图感知的提示增强模块,把用户要求展开成内容和版式细节。
OpenHands:让 AI 在沙箱里写代码、用终端
OpenHands 的早期论文介绍了通用软件开发智能体平台,支持编写代码、使用命令行和浏览网页,并把执行过程放入沙箱环境。它也允许多个智能体协作和接入评测基准。
IDM 改善少步生图中的文字和细节
Intrinsic Distribution Matching 在分布匹配蒸馏中加入显式的特征统计约束,用生成器自身的指数移动平均副本提供特征,避免额外引入独立的特征编码器。
nanoMuse 探索跨手机和电脑的个人智能体
nanoMuse 技术报告提出跨设备共享对话的个人智能体,由用户自行运行中继服务,并选择底层模型。记忆以可阅读文件保存,动作经过专门的检查环节。
MinerU2.5 先看版式,再识别文档细节
MinerU2.5 的研究采用两阶段文档解析:先在低分辨率图像中识别全局结构,再根据版式从原图裁出文字、公式和表格,进行局部精细识别。
投资研究基准给 AI 加上信息时间边界
Investor’s Last Exam 用带版本和时间戳的金融数据库测试智能体,要求模型只能使用决策时已经存在的材料,避免在预测过去事件时偷看后来的结果。
ReLift 通过修补轨迹改善视频 3D 跟踪
ReLift 先利用现有二维跟踪器和几何模型得到初始三维轨迹,再专门修复深度错误、对应关系错误和被遮挡部分的运动。
研究回顾:Mem0 为智能体整理长期记忆
Mem0 从持续对话中提取、合并并检索重要信息,避免每次都把全部历史塞进上下文。论文还介绍了使用图结构表示记忆关系的变体。
PaddleOCR VL 1.6 针对薄弱区域改进训练
PaddleOCR-VL-1.6 沿用紧凑文档解析模型的方向,先找出上一版中不稳定、覆盖不足或标注不可靠的区域,再针对这些问题增强数据。
ARIS 用不同模型交叉审查自动科研结果
ARIS 是一个自动科研执行框架,默认建议由一个模型推进研究,另一个模型家族的审查者检查中间产物并要求修改。它特别关注看似成功、实际上证据不足的实验结论。
SmolDocling 用小模型保留文档结构与位置
SmolDocling 采用约 256M 参数的视觉语言模型,把整页文档转换为 DocTags 标记,记录内容、结构和空间位置,覆盖表格、代码、公式与列表等元素。
NCM 先生成概念层次,再细化文本
Next-Concept Modeling 把文本编码成多层离散表示,先确定较粗的概念,再逐层细化;同一层中的编码可以并行预测,减少逐字生成的串行开销。
OmniFlatten 研究能打断、能接话的语音对话
OmniFlatten 探索全双工语音对话,让系统在接收声音的同时生成回应,更接近人类对话中的插话、简短回应和语音重叠。
SUPRA Tex 按参考图补全 3D 材质
SUPRA-Tex 将单图材质生成分成可见材质估计、表面对齐和未见区域补全,先保留参考图中已有的证据,再生成其余部分。
研究尝试让 AI 文本检测结果可以解释
一项研究使用稀疏自编码器提取文本检测器内部的特征,再筛选可用人类语言解释的概念,训练一个较轻的分类器。目标是说明模型为什么把一段文字判为 AI 生成。
Hy Nomas 让视频世界模型连续接受指令
Hy-Nomas 采用 8B 扩散主干,支持多轮文字指令与连续相机控制。模型结合当前输入和缓存历史生成不同长度的视频片段,并让动作指令只作用于对应时间范围。
YuE2 先写乐谱,再生成完整歌曲
YuE2 将符号音乐规划和音频生成放进同一个系统:先生成可阅读的旋律与和声结构,再展开为音乐 token,最后生成完整歌曲音频。
研究回顾:时间序列也能预训练基础模型
一篇时间序列研究借鉴语言模型的预训练方法,将大量序列切成片段交给解码式注意力模型,尝试不针对每个数据集单独训练就进行预测。
CaPtain 训练小模型用代码控制机器人
CaPtain 将机器人控制表达为调用感知、几何和受保护运动接口的代码,再通过监督微调及多轮强化学习训练小型视觉语言模型。
AI Infra Guard 分层检查智能体安全
AI-Infra-Guard 将安全检查分成基础设施、工具协议、智能体行为和模型四层,分别采用规则匹配、代码审查和行为测试等方式,而不是用一种检测器覆盖全部风险。
研究回顾:Transformers 如何统一模型接口
Hugging Face 的 Transformers 早期论文介绍了统一模型架构接口和预训练模型集合的设计,让研究者能够扩展新架构,也让开发者更容易复用已有模型。
COLLEAGUE.SKILL 把经验资料整理成可修改技能包
COLLEAGUE.SKILL 从某个角色或个人提供的材料中提取实践方法、判断习惯和沟通规则,生成带版本的智能体技能包,方便检查、修正和迁移。
WeVisOne VL 统一物体定位、分割和 OCR
WeVisOne-VL 将物体级和像素级感知接入同一个视觉语言模型,覆盖检测、定位、计数、OCR、分割和抠图。模型通过特殊对象标记连接轻量像素解码器。
InteractiveWorld 测试 AI 能否指导人完成实物任务
InteractiveWorld 让 AI 助手在模拟环境中指导一个会观察、理解并独立行动的人类代理,检验多轮建议如何影响后续结果。
RAG Anything 把图表公式一起纳入检索
RAG-Anything 将文字、图像、表格和公式视为相互关联的知识实体,通过双图结构组织跨模态关系与文本语义,再结合结构导航和语义匹配检索。
Zep 用时间知识图谱组织智能体记忆
Zep 的研究通过 Graphiti 将持续对话和结构化业务数据整合进具有时间信息的知识图谱,在保留历史关系的同时更新新信息。
OmniEdu 将解题与教学支持一起训练
OmniEdu 面向基础教育,把训练能力分为学科知识、课程理解、学习困难诊断以及教学支架,而不是仅按资料来源堆叠样本。
PDFMathTranslate 翻译论文时尽量保留版式
PDFMathTranslate 将语言模型与版式检测结合,翻译科学文档的同时尽量保留原有布局,让读者更容易对照公式、图表和正文。
安全研究关注正常任务中的危险输出
一项安全研究提出“内部安全坍塌”现象:在某些专业任务条件下,模型可能持续生成有害内容,即使任务表面看起来属于正常工作。
Prime Agent 把长期任务的上下文留在外部环境
Prime Agent 使用持久化 IPython 环境处理上下文和计算,并保存历史、记忆、技能及子智能体配置,支持长流程评测与编程任务。
DynaFlow 学习何时让多个智能体协作
DynaFlow 让主智能体按任务生成可执行的协作程序,自行决定顺序、并行、信息交换和验证步骤,而不是固定使用同一套分工。
AutoTavern 研究让 AI 团队开发游戏对战系统
AutoTavern 研究让多个语言模型智能体协作搭建游戏模拟器、训练对战策略并迭代实验流程,由人设定目标和处理规则歧义。
UniMate 尝试用一个模型驱动多种骨架动画
UniMate 根据绑定骨架的 3D 资产与文字提示生成动作,将骨架拓扑加入扩散模型的注意力机制,减少每一种骨架都重新训练或微调的需求。
bitnet.cpp 为低比特模型设计端侧推理
bitnet.cpp 的研究针对 BitNet b1.58 等三值权重模型设计推理系统,围绕混合精度矩阵计算引入查找表和带缩放的低比特计算方案。
Prism 用动态稀疏注意力训练 2K 音视频模型
Prism 根据画面变化和音频对视觉区域的影响,动态安排时空分块及注意力连接,让联合音视频模型把计算更多用于信息丰富的位置。
LingBot Map 从视频流连续重建三维场景
LingBot-Map 通过几何上下文 Transformer,从连续视频恢复相机姿态和点云。它组合锚点上下文、姿态参考窗口和轨迹记忆,以处理坐标对齐、几何细节和长期漂移。
DeepSeek 公开 Super-agent 协作研究原型
DeepSeek 团队在 GitHub 公开 dsh-superagent-prototype,探索怎样让编程智能体围绕一个仓库协作。它监听 GitHub 以及可选的飞书消息,在收到允许的请求后建立工作项,以独立会话和目录执行任务,再回到原对话交付结果。
rerun 把 AI 同事接入团队工具与定时任务
rerun 是一个可自行托管的 AI 工作助手项目。它将工具接入、按计划执行和人工确认组织在同一套工作方式里,让代理在需要决策时回到用户处。
Agentic RL Lab 用实验代码拆解智能体强化学习
Agentic RL Lab 汇集多个语言模型与智能体强化学习算法的复现记录,包含 GRPO、GSPO、DAPO、Search-R1 等方向。作者用 PyTRIO 等训练接口减少实验中的基础设施负担。
AnyModelBot 把本地 AI 助手接到聊天工具
AnyModelBot 是支持 Windows、macOS 和 Linux 的本地优先智能体应用。不同机器人可以保留各自的模型、工作区与记忆,并通过微信、飞书等聊天入口交互。
DeepSeek Harness 用插件组织智能体能力
DeepSeek Harness 是 DeepSeek AI 开源的智能体执行框架,以 Cordis 为基础,采用插件化架构组织能力。项目提供独立文档与扩展入口。
Mika 尝试在手机后台操作 App 完成任务
Mika 是一个手机 AI 助理项目,用户描述需求后,它可以在应用与网页中执行步骤。项目展示了利用后台屏幕操作的方式,以减少对前台使用的打断。
Pestinha 用小型神经网络驱动桌面宠物
Pestinha 是面向 Windows、macOS 和 Linux 的桌面宠物实验项目。角色使用小型脉冲神经网络,根据电脑上的活动和用户互动形成不同表现。
REA 用智能体辅助理解应用与二进制行为
REA 是一个面向软件分析的开源项目,尝试把智能体与检查工具结合,帮助开发者理解某项功能的实现行为。仓库提供展示案例与文档入口。
Scenario Skills 连接创作工具与编程智能体
Scenario Skills 为 Claude Code、Codex、Cursor 等智能体提供创作流程,覆盖图像、视频、音频、纹理和三维资产。常规技能通过 Scenario MCP 服务执行。
Spec Kit 用需求规格和模板组织 AI 开发
Spec Kit 提供结构化流程、可复用模板和过程记录,让编程智能体围绕明确需求工作。开发者可以采用现成流程,也可以自定义组织方式。
Google 探索用“睡眠阶段”巩固模型新知识
Google Research 介绍一种持续学习框架,把模型的活跃交互阶段与离线记忆巩固阶段交替安排。短期上下文通过额外的记忆模块与训练过程转为较长期的参数知识,目标是减轻学习新内容时遗忘旧能力的问题。
Anthropic 扩大面向科研机构的 Claude 支持
Anthropic 扩展 AI for Science 计划,公布与 20 家科学基金会、研究机构和团队的合作。计划通过提供 Claude 使用额度,支持生物、医学、物理、化学、气候与数学等领域的项目。
claude-mem 为编程助手保留跨会话上下文
claude-mem 自动记录工具使用中的观察结果,生成语义摘要,并在后续会话中提供相关上下文。它试图减少会话结束或重新连接后重复交代项目背景的成本。
Google 介绍 AI 辅助结核病筛查的落地进展
Google Research 介绍了与 Nexus AI 合作的胸部 X 光筛查项目,目标是在放射科资源不足的地区辅助识别疑似结核病患者。公告回顾了从算法研究、临床验证到合作部署的过程。
Anthropic 扩大美国政府 Claude 采购折扣
Anthropic 宣布扩大与美国总务署 GSA 的合作,为符合条件的政府客户提供 Claude Enterprise、Claude for Government 和 API 的四成折扣,覆盖范围也扩展到州、地方、部落和领地政府。
AI 辅助超声研究面向基层孕产检查
Google Research 公布一项前瞻性多中心研究,探索让经过流程培训、但非专业超声技师的一线人员使用低成本探头采集扫查数据,再由 AI 辅助评估孕周。
小米 OCR 模型用 0.8B 参数解析文档
小米研究团队公开 Xiaomi-OCR-0,面向文档解析和围绕文字的视觉理解。模型基于 Qwen3.5-0.8B-Base,官方模型卡介绍了约 1.7 亿条训练样本及渐进式训练流程。
Google 让 AI 智能体接入真实生物实验流程
Google Research 介绍了将智能体与湿实验室机器人连接的研究。系统围绕分子设计提出候选方案,再通过真实实验反馈调整下一轮探索,形成设计、测试与分析的循环。
Google 地理智能体连接地图与环境模型
Google Research 介绍了实验性的地理推理智能体,将 Gemini 与天气、洪水、人口动态、遥感及地图工具连接起来,先制定分析计划,再处理跨数据源任务。
Anthropic 将 Agent Skills 捐给开放基金会
Anthropic 宣布把 Agent Skills 开放标准捐赠给 Linux 基金会旗下的 Agentic AI Foundation。移交内容包括名称和标识、GitHub 组织以及 agentskills.io 域名。
物理学家 Stubbs 加入 Anthropic 长期利益信托
Anthropic 宣布,实验物理学家、哈佛大学前科学学院院长 Christopher Stubbs 加入公司的长期利益信托。他的研究背景包括观测宇宙学和精密测量,也曾参与政府科技咨询。
T3 Code 统一管理电脑上的编程智能体
T3 Code 提供移动端、网页和 Electron 桌面端界面,用于控制已经在用户电脑上配置好的编程智能体。项目列出了 Claude Code、Codex、Cursor 等接入路径。
Google 开放 Deep Review,辅助核查技术文档
Google Research 宣布公开推出 Deep Review,将复杂技术文档的反馈与核查能力从学术论文扩展到更多知识文档。公告提到,系统此前已在多个计算机科学会议的投稿场景中使用。
Kronos 用金融 K 线训练专用基础模型
Kronos 是面向金融 K 线序列的开放模型项目。团队使用来自多个交易所的数据预训练,尝试学习价格与交易量等序列的表示,而不是直接套用通用文本模型。
Liquid d1 把分类判断压缩为一次前向计算
Liquid AI 的 d1-2B 面向路由、分类、文档提取、审核和重排序等判断任务。它接收文字、图片或视频,通过一次前向计算返回结果,不像聊天模型那样逐个生成回答 token。
Google 研究:AI 提升产出,不一定同步提升技能
Google Research 介绍了一项持续三个月的专利律师随机试验,参与者来自 11 家律所。研究既观察使用 AI 时的工作质量,也在移除工具后检查独立判断能力。
Claude 代员工买卖二手物品,完成 186 笔交易
Anthropic 公布 Project Deal 市场实验,让 69 名员工各自配置的 Claude 代理在内部渠道发布物品、还价和成交。真实执行的一轮共达成 186 笔交易,总额略高于 4,000 美元。
Kornia 把可微视觉与几何算法接入 PyTorch
Kornia 是基于 PyTorch 的计算机视觉库,提供可微图像处理、数据增强和几何视觉算法,支持批量变换、自动微分与 GPU 计算。
Google 用地理表示补充公共卫生数据
Google Research 展示了 Earth AI 人口动态基础模型在公共卫生中的五组合作案例。模型将搜索趋势、人口流动、环境和建成区等信号压缩为地点表示,再接入既有统计或机器学习流程。
Claude 辅助毅力号规划火星行驶路线
Anthropic 回顾了 Claude 参与 NASA 毅力号火星车路线规划的实验。相关行驶发生在 2025 年 12 月,JPL 工程师让模型结合影像与任务资料编写路线指令,涉及约 400 米的路径。
Google 报告讨论智能体该如何分享个人信息
Google Research 发布关于智能体隐私与安全的研讨报告,汇集多家机构的研究者观点。报告认为,能访问数据、调用工具的智能体,需要理解特定场景下哪些信息流动是合适的。
Anthropic 称防护措施减少了未授权蒸馏采集
Anthropic 公布针对未授权模型蒸馏的数据采集防护进展。公司称,初步证据显示相关措施使被采集的数据量减少约 90% 至 99%。
Idol 从单张图片生成 3D 高斯模型
Sperid Labs 的 Idol 可以把一张物体图片转换为 3D Gaussian Splat,先去除背景、确定物体范围,再生成可由常见查看器打开的 PLY 文件。作者报告可输出超过一百万个高斯单元。
Google 联邦学习引入可验证的隐私机制
Google Research 介绍新一代联邦学习系统,利用可信执行环境提供可远程验证的计算逻辑,并把部分计算移到服务器以改善训练效率和设备覆盖。
Anthropic 拟设公益基金,初始投入 5% 股权
Anthropic 宣布设立全资持有的 Public Benefit Fund,并计划在股东批准后投入 5% 股权。公司价值在设定基准上每增长 50%,董事会可酌情追加 2% 股权。
Liquid LFM3 语音模型支持本地边说边转写
LFM3-Audio-2B 接收文字或音频,能够输出文字、语音或两者交织的回答,面向笔记本和边缘设备。模型采用自研音频编码器及 LiquidCodec,并提供转写和语音合成示例。
Diffusion Controller 让生图更贴近提示要求
Google Research 的 Diffusion Controller 将去噪过程视为连续控制问题,加入轻量控制网络,试图在保留图像质量的同时改善对用户提示和视觉约束的遵循。
Anthropic 向 METR 开放更深入的评估权限
Anthropic 表示,已开始向非营利评估机构 METR 的团队提供接近员工级别的信息访问权限,以支持对前沿模型和安全实践的独立评估。METR 将公开风险评估结果。
Pika H3 Flex 开放视频与同步音频生成
Pika H3 Flex 用六步采样生成视频和同步音频,并通过参考素材及提示控制镜头。公开模型支持本地 480p、768p 原生输出,托管 API 则提供更高分辨率和额外制作功能。
Anthropic 更新美国中期选举防护措施
Anthropic 公布了美国中期选举前的防护安排,包括识别滥用、检查政治偏向,并把投票相关问题引向可靠信息来源。公司称,Claude 会在选民登记、投票地点和日期等问题中提供通往 TurboVote 的入口。
Clover 把块扩散引入 35B 混合专家语言模型
DiffuSpace 的 Clover-35B-A3B-Preview 基于 Qwen3.6 架构,结合块扩散生成与混合专家机制,总参数约 35B,每 token 激活约 3B 参数,支持 128K 上下文。
Anthropic 在新加坡设立办公室并签署合作备忘录
Anthropic 宣布在新加坡开设亚太地区第五个办公室,并与新加坡数码发展及新闻部签署合作备忘录。双方计划围绕 AI 安全、模型评估、采用情况研究和负责任部署开展合作。
Mistral Large 4 发布多模态开放权重
Mistral 在官方模型库公开 Large 4,一款万亿总参数规模的原生多模态混合专家模型。官方把指令跟随、推理、编程和智能体流程整合进同一组权重,并提供 API 与量化版本。
Anthropic 推出 Cyber Mission 支持网络防御
Anthropic 宣布 Cyber Mission,计划通过模型、工程人员、研究和资金支持关键基础设施及开源软件的安全维护。首批关键基础设施合作伙伴包括工业安全厂商、咨询机构和设备提供商。
LFM3 视觉模型面向端侧文档和屏幕理解
Liquid AI 的 LFM3-VL-2B 接收文字、图像与视频,面向本地文档阅读、图表理解、屏幕识别和物体定位。模型把 LFM3 语言部分与新的自研视觉编码器结合。
Anthropic 使用政策将于 11 月 12 日更新
Anthropic 公布 2026 年使用政策更新,生效时间为 11 月 12 日。新版本进一步说明了欺骗性活动、武器相关软件、监控,以及医疗、金融等高风险用途的要求。
LFM3 Omni 用一个本地模型处理图文音视频
LFM3-Omni-2B 是 Liquid AI 的端到端全模态模型,可以理解文字、图像、视频和音频,并用文字或语音回答。其目标是在端侧把原本分开的识别、视觉理解、语言和语音合成组件合并。
Anthropic 承诺三年投入 1.5 亿美元支持科研
Anthropic 宣布未来三年向美国 Genesis Mission 承诺投入 1.5 亿美元,用于扩大参与机构的 Claude 使用范围。涉及机构包括 NASA、美国国立卫生研究院及国家科学基金会等 15 家以上单位。
英伟达 Nemotron 转写模型支持一小时录音
英伟达公开 Nemotron 3.5 Transcribe,支持 40 种语言的离线转写,可处理最长一小时录音,并提供翻译、说话人归属、时间戳和音频问答等功能。权重包含多种精度版本。
Claude 网络安全验证计划扩展为三级访问
Anthropic 将网络安全验证计划扩展为防御、红队和专项访问三个层级,并把此前 Project Glasswing 的相关安排整合进来。申请方可按工作范围接受不同程度的身份与用途审核。
Liquid LFM3 面向本地小型智能体
Liquid AI 的 LFM3-1.7B 采用新的三混合架构,面向本地智能体、工具调用、结构化输出和领域定制。官方提供原始模型和 GGUF 版本,方便按推理框架与硬件选择。
Anthropic 拟投入 1 亿美元培训 AI 部署工程师
Anthropic 推出 Claude Frontier Academy,承诺投入 1 亿美元,目标是在 2027 年底前培养一万名 Frontier Deployed Engineers。首批参与机构包括多家咨询公司、银行和企业。
Unlimited OCR 2 支持一次解析多页文档
百度的 Unlimited OCR 2 提供 Transformers 和 SGLang 使用方式,支持将整份文档的页面按顺序放入同一个请求,从而在解析中利用跨页上下文。
南北阁 4.3 先推 33B 教师模型
南北阁公开 Nanbeige4.3-33B,重点面向编程和职业协作任务。团队先构建较高能力的教师智能体,再计划将相关能力蒸馏到更小的模型。
Spark X2.6 小模型强化端侧工具任务
Spark-X2.6-4B 保持上一代的架构,通过改进后训练增强编程、智能体、多语言和长上下文能力。官方公开了 Transformers 格式权重,以及部署和推理配置示例。
Flint 开放面向编程智能体的混合专家模型
Recursive 的 Flint 面向代码库调查、修复错误、实现功能和编写测试,支持文字输入输出、推理及多轮工具调用。模型约有 39.8B 总参数,每 token 激活约 2.5B 参数。
DeepSeek V4.1 Flash 更新推理与工具调用支持
DeepSeek 官方公布 V4.1-Flash-1017 小版本更新,称其改善了推理、编程、智能体和视觉任务,并减少部分任务的执行时间与输出长度。模型与仓库采用 MIT 许可证。
FLUX 3 Klein 提供 ComfyUI 图像编辑权重
Black Forest Labs 提供面向 ComfyUI 的 FLUX 3 Image Klein 文件,支持指令编辑、文生图、最多十张参考图组合及边界框布局控制。文件包包含基础和蒸馏版本,以及不同精度选项。
SAM 3 用文字提示分割图片和视频中的物体
Meta 的 SAM 3 支持文字或视觉提示,可检测、分割并跟踪符合某个概念的物体。相比只指定一个位置,它能够按短语或示例寻找图像中所有匹配实例。
Qwen 3.8 27B 开放视觉与智能体能力
Qwen 官方公开 Qwen3.8-27B 权重,支持图像、视频理解和可调思考模式,重点加强编程、专业工作、研究及长流程智能体任务。模型沿用 Qwen3.5 的架构基础。
LTX 2.5 开放本地音视频生成组件
Lightricks 的 LTX-2.5 提供开放权重,可根据文字、图像和视频输入生成同步音视频,并支持本地运行和微调。文件按组件拆分,方便与 ComfyUI 工作流及命令行管线衔接。
AI 编程实验:Astro 与 Next.js 成本对比

开发者 Nolan Lawson 于10月28日公布一项实验:让 AI 分别使用不同 JavaScript 框架,开发同一个宝可梦应用,再比较开发时间、token 消耗、代码量和页面表现。
Anthropic 申请 IPO,拟登陆纳斯达克
Anthropic 于10月26日宣布,已向美国证券交易委员会(SEC)提交 S-1 注册文件,计划进行首次公开募股。
ChatGPT 与 Codex 将于 12 月共享额度
OpenAI 帮助中心公布,Plus、Pro 和 Business 套餐从12月起将在 ChatGPT 与 Codex 之间共享使用额度。该调整与 Work 的代理能力进入 ChatGPT 主体验同步推进。
Claude Code 限制复刻特定现有游戏

Anthropic 向 Game Developer 确认,公司调整了 Claude Code 针对 Opus 5.5 的系统提示,引导工具拒绝复刻他人某一款特定游戏。
fal 谈 AI 视频:下一步是可控生成

fal 联合创始人 Gorkem Yurtseven 与工程负责人 Batuhan Taskaya 在 a16z 的一期访谈中,介绍了视频模型 H3 Max 的优化,以及能够持续接收新指令的连续视频试验。节目于9月17日发布,由 Jennifer Li 主持。
富士胶片投资百亿日元扩产存储磁带

富士胶片10月29日宣布,将在2026至2028财年投资约100亿日元,扩大神奈川县小田原基地的数据存储磁带产能。公司计划将出货能力提升至2025财年的约五倍。
Google 加码 AI 搜索广告,搜索收入仍增长

据 Ars Technica 报道,Google 的 AI 搜索在单次查询变现方面仍落后于传统搜索,公司正通过增加广告改善商业化表现。
OpenAI拟将数据中心改称“AI计算园区”
据 Axios 报道,OpenAI 拟将数据中心称为“AI 计算园区”。目前,这一名称仍属于报道中的计划。
WSJ:OpenAI 融资承诺低于原定目标

《华尔街日报》援引知情人士称,OpenAI 新一轮融资目前获得约110亿美元承诺,低于最初300亿美元的募集目标。
Reddit 三季度营收增 53%,股价仍下跌

Reddit 于10月29日公布2026年第三季度业绩:营收8.95亿美元,同比增长53%;日活跃独立用户指标 DAUq 达到1.303亿,同比增长12%。
担心 AI 复刻,《ReVamp》缩小公测

《ReVamp》开发商 Digital Sun 调整了游戏测试计划。团队担心未发售内容被 AI 快速复刻,将原本计划的大规模公开测试改为人数更少的私下测试。
特斯拉 FSD 用户增长,继续推进 AI 业务

特斯拉在2026年第三季度披露中继续强调 AI、机器人和软件业务,并在 SEC 季度报告中提及 FSD(Supervised)订阅增长带来的影响。
Treg:让 AI 助手查找企业与联系人
Treg 提供了一个连接外部工具的统一入口,可供 Claude Code、Codex 等 AI 助手执行企业搜索、联系人信息补充和工作邮箱验证。
发现新内容
 AI 导航
灵构AI笔记
AI笔记工具,融合笔记、AI创作和知识管理,辅助用户整理思路、高效创作及团队协作。
 AI 导航
宙语Cosmos
AI创作平台,支持多模态内容生成,快速产出营销文案和创意内容,提升内容生产效率。
社区
作品展示:我做了一个小红书选题分析表
用表格抓取竞品选题、评论关键词和标题结构,自动生成下周内容池。
 AI 导航
魔撰写作
AI智能写作平台,快速生成高质量内容,提供润色、改写和校对等功能,提升写作效率。
AI 产品调研资料包:从竞品到功能拆解
资源
适合做产品选题和课程案例分析,包含调研维度、截图规范和复盘模板。

ContentBot
AI 导航
AI内容生成助手,快速创作多种语言、格式的内容,助力营销和内容创作。
提示词的基本结构
课程
掌握角色、目标、上下文、约束和输出格式五个核心部分。

5118 SEO优化精灵
AI 导航
专业SEO优化工具,AI辅助生成SEO文案,提升网站内容质量和搜索引擎排名。
测试测啊测测测
社区
测试啊测测测测试啊测测测
团队 AI 协作软件对比
资源
从权限、知识库、流程、审计和成本看团队型 AI 软件怎么选。
AI 产品商业化与会员体系
课程
设计价格、权益、内容分层和增长路径,让 AI 产品可持续运营。
精选资源
更多
AI 工具
AI 产品调研资料包:从竞品到功能拆解
适合做产品选题和课程案例分析,包含调研维度、截图规范和复盘模板。
资料包
提示词模板
提示词结构检查清单
把目标、上下文、约束、样例和输出格式整理成一张可复用检查表。
模板
模型与 APIPremium
RAG 工具链选型地图
按文档解析、向量库、编排、评测和观测拆开看,适合项目启动前收藏。
选型
AI 工具Basic
浏览器 AI 插件组合:网页研究与资料整理
适合日常阅读、网页总结、批量摘录和研究资料同步。
插件清单
AI 工具Basic
生图生视频工具速查表
把文生图、图生图、局部重绘和视频生成按适用场景分组。
工具清单
AI 工具Premium
个人知识库软件组合:本地优先的做法
适合隐私文档、课程笔记和长期资料库,附带同步与备份建议。
软件方案
AI 工具Premium
Agent 工作流工具:从触发到日志
整理适合自动化工作流的工具入口,重点看权限、失败重试和可观测性。
工具清单
AI 工具
AI 学习路线清单:入门到项目化
按基础概念、提示词、工具实践、RAG 和 Agent 项目拆成阶段。
指南
模型与 APIBasic
模型能力榜单怎么看
把推理、代码、视觉、多模态和成本放在一起,避免只看单一分数。
指南