 开发工具

11 月 20 日,工程师 Ankit Gupta 公开了一份实验记录:他用编程智能体让语言模型在 FPGA 上运行,再持续调整实现。FPGA 可以重新配置电路;这项实验使用现有硬件,目标是优化推理路径,没有制造一块新的专用芯片。
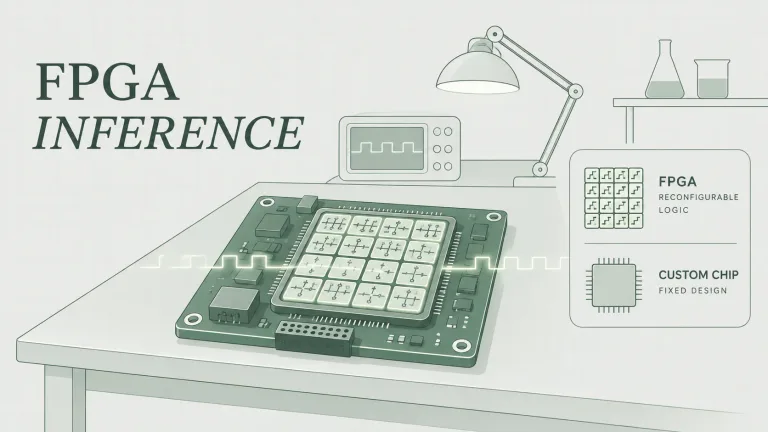
作者先要求完整模型给出逐位一致的结果,以此建立约每秒 6 个词元的初始基线,再用数天时间迭代多轮实现。按作者发布的数据,最终测试达到每秒约 213 个词元。约 33 倍这个数字来自同一实验中前后两个版本的比较。
Gupta 称在数百次实验中使用了约 1 万美元的 Claude 和 OpenAI 词元。这个金额单指模型调用成本。模型、硬件配置和验证方式都会影响性能,因此这份日志更适合用来了解一次硬件优化的过程,不能用作 FPGA 与商用 GPU 的通用速度比较。
配图为 GETAI 原创 AI 主题插画。