 开发工具

参与 AMD Loom 项目的开发者 sa1sr1 发布了一组本地推理测试。他让搭载 Gemini 4 Neon 的编程智能体为 Inkling-2-Mini 调整计算内核,使用公开的量化权重,约 4.3 小时后完成优化和正确性检查。
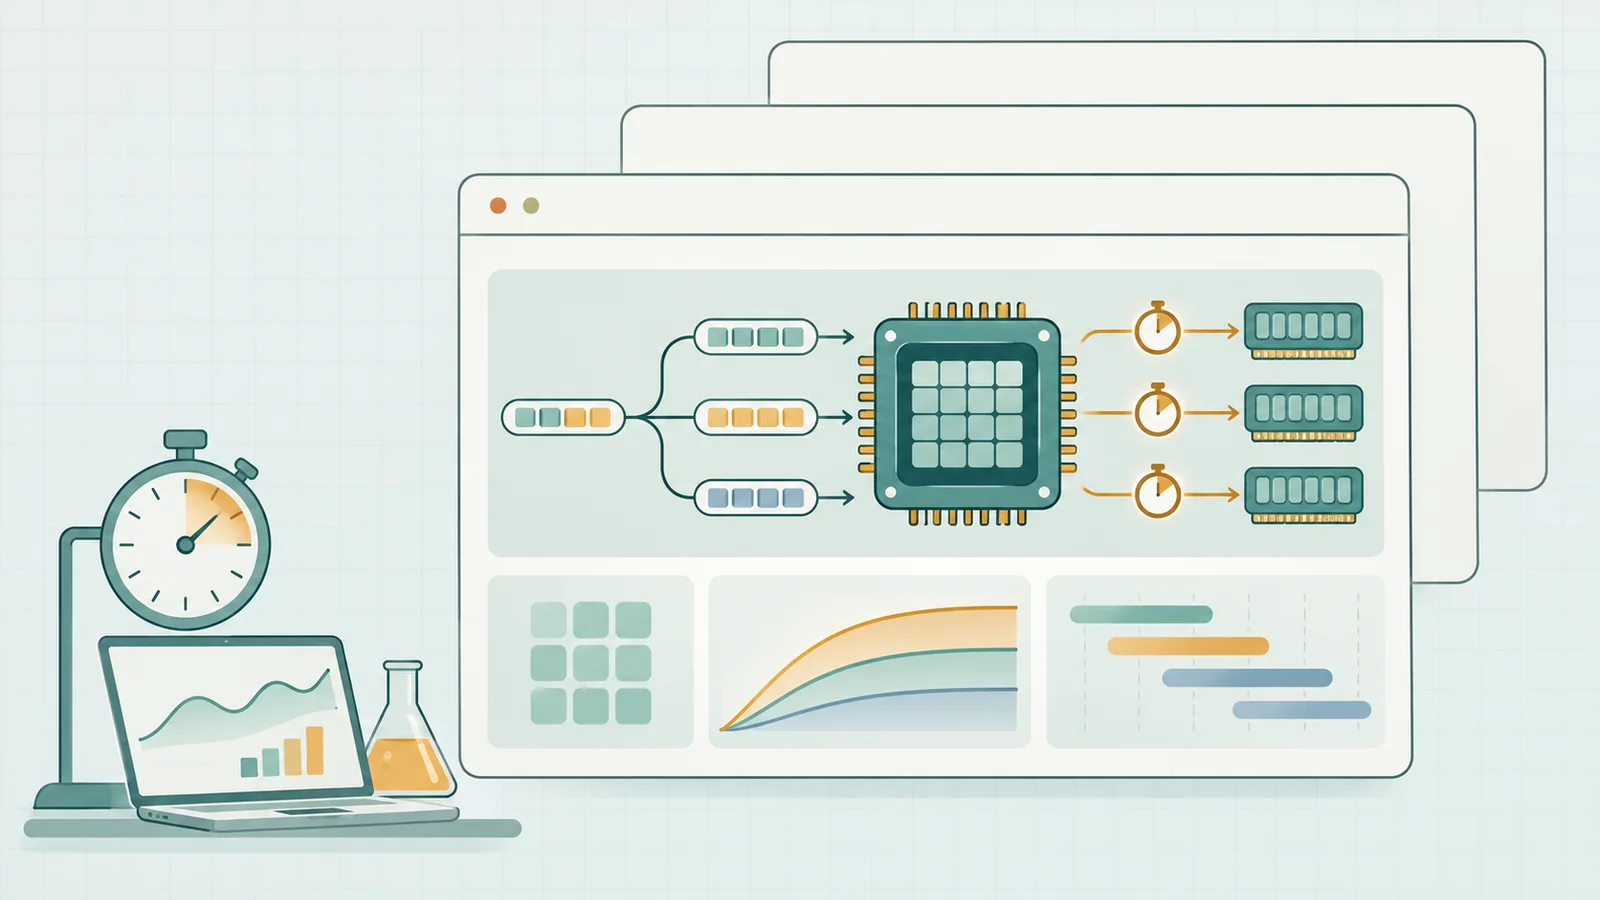
在配有 128 GB 内存的 Strix Halo 8060S 上,Loom 单路解码达到每秒 44.8 个词元。同机使用同一份权重,llama.cpp 的 ROCm 后端为 23.8,Vulkan 为 20.8。解码衡量逐个生成词元的速度,不能直接用这个数推算整段提示词的处理时间。
作者随文提供了模型包,并说明 llama.cpp 当时刚加入这一模型的支持。因此这组数字描述的是首日软件版本、特定权重和硬件的实测结果。