
 研究

METR 11 月 20 日发布第四季度评估。团队把任务长度定义为人完成它所需的时间,再估计模型成功率达到 50% 时对应多长的任务。
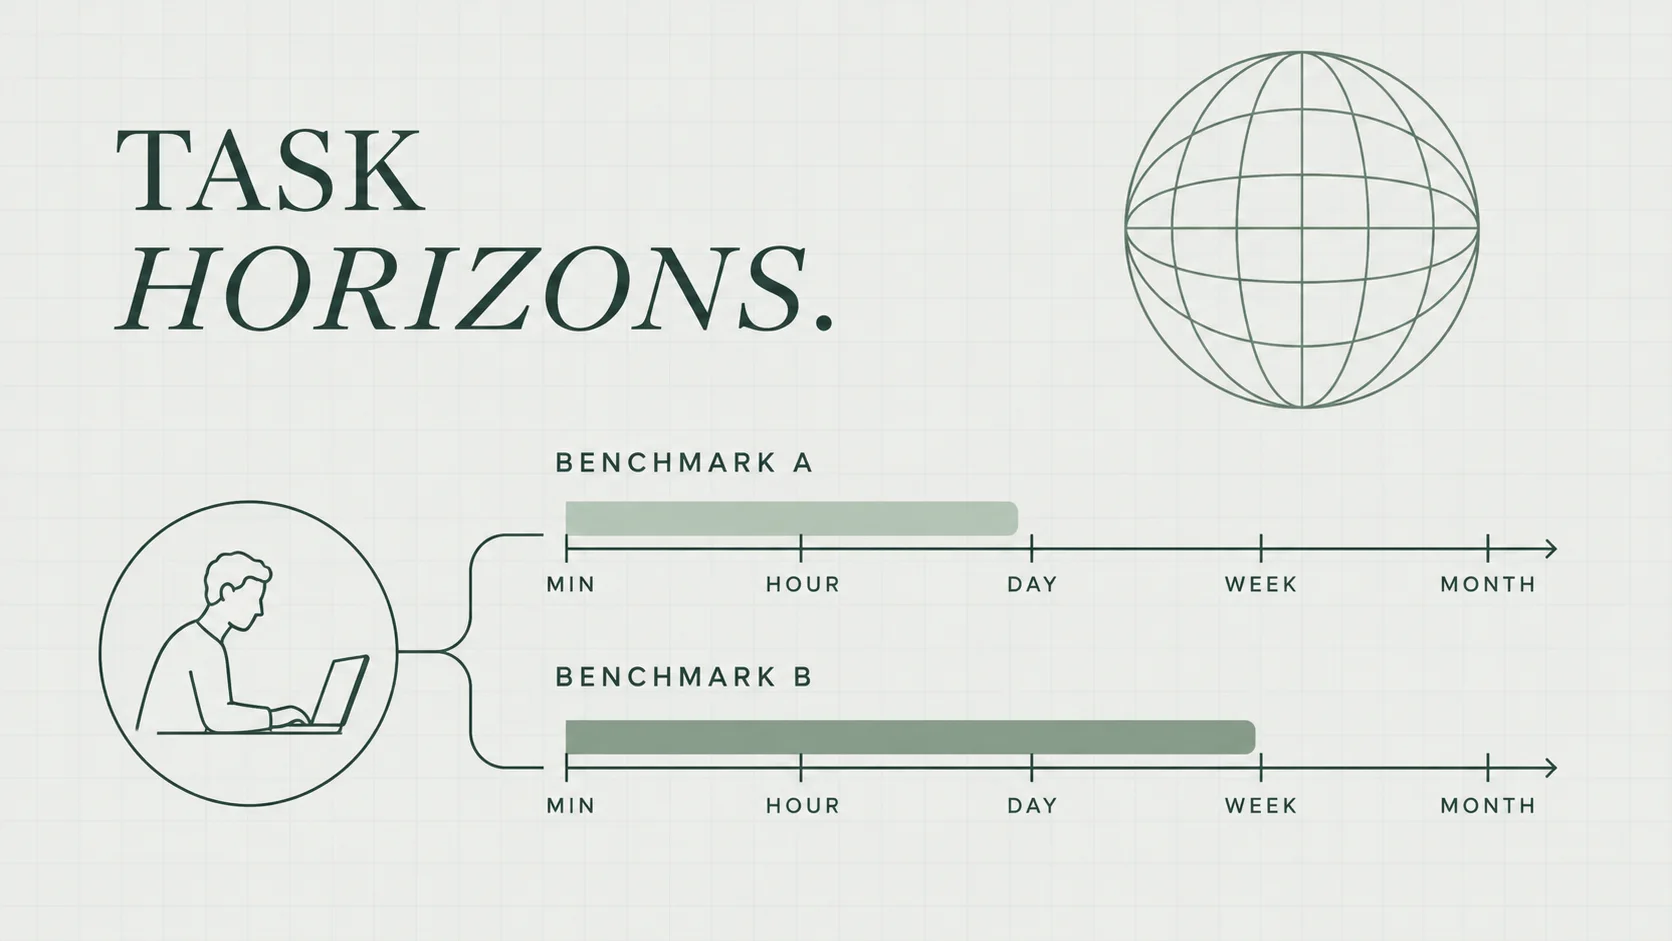
较早的 TH1.1 题库中,前沿模型在不少任务上已接近满分。加入难度更高的 TH2 后,同一模型的时间跨度估值下降。合并题集后,团队得到约 3.6 个月翻一倍的历史趋势。
报告也单列了判断力的限制。在反馈慢或测试不足以说明方案能否泛化时,智能体更难做出专家水平的取舍。因此这条增长曲线不能用来推定它能独立接手任意一周的工作。
配图为 GETAI 原创 AI 主题插画。