
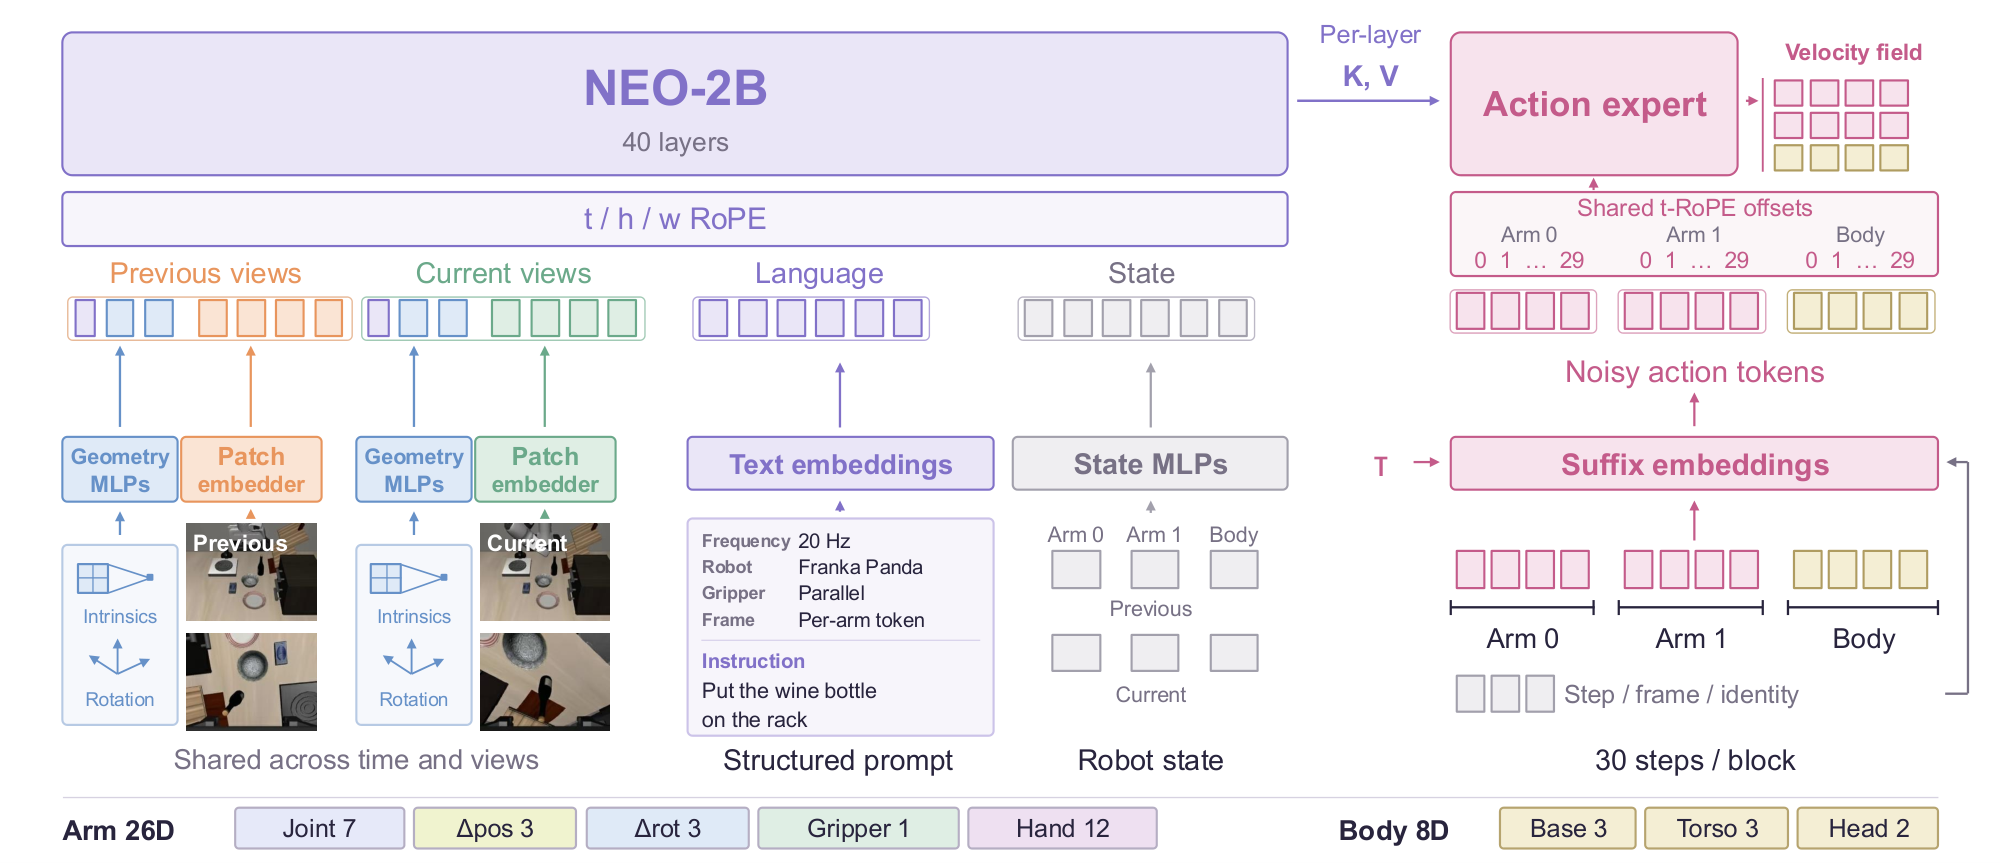
研究团队在 11 月 4 日提交 NEO-VLA 预印本,论文于 11 月 5 日登上 Hugging Face 每日论文榜。研究关注机器人操作中容易被视觉编码压缩掉的信息,例如物体边界、局部几何和深度变化。
NEO-VLA 先将图像切成视觉 token,让它们和语言指令一起在主干网络里更新。动作模块可以读取多个深度的视觉特征,而不只依赖视觉编码器最后一层的输出。
在论文设定的操作任务中,作者报告这种设计优于受控对照中的独立视觉编码方案,并通过分层探测发现部分与动作有关的线索在较早的网络层就已最清晰。
配图:Weichen Fan 等的NEO-VLA 论文模型架构图,按 CC BY 4.0 使用。

来源:arXiv · Hugging Face 论文页。