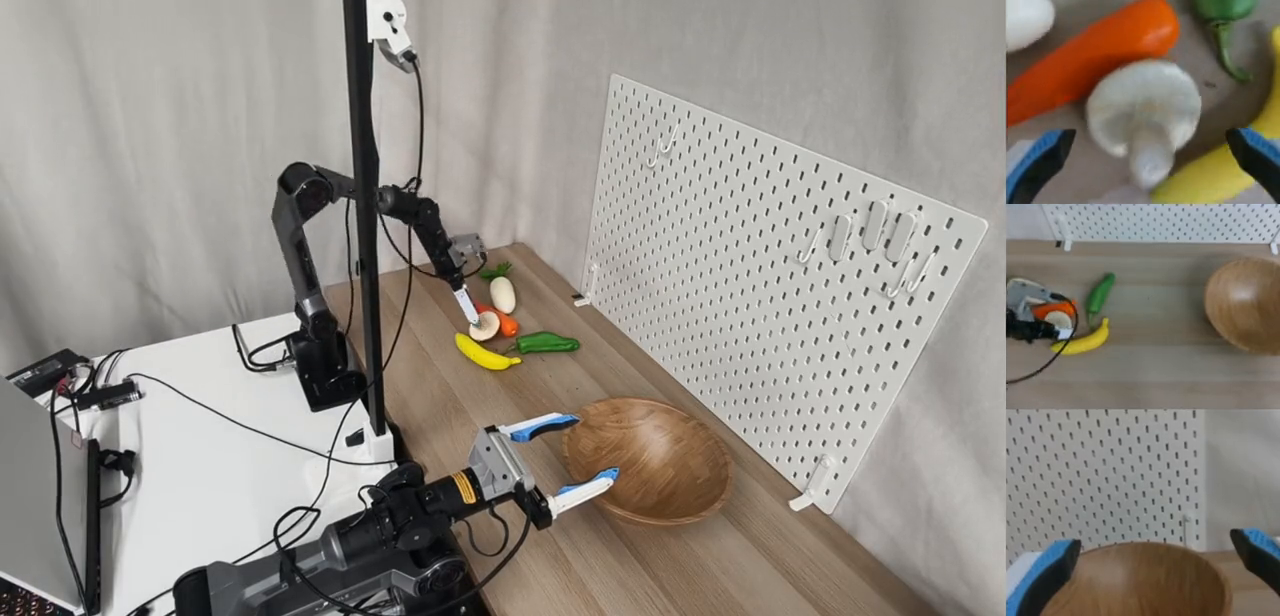
11 月 5 日提交的 SLA 预印本提出在视觉、语言与动作模型的持续预训练中加入三维空间监督。训练时,机器人策略既学习预测动作,也尝试让中间视觉特征对齐一个固定的三维感知模型。 方法利用不同机器人数据中已有的 RGB、深度或相机标定信息。论文称额外组件仅在训练时使用,部署时可保留原策略的推理结构。 来源:arXiv。 演示截图:SLA 研究团队。截自官方演示视频。