
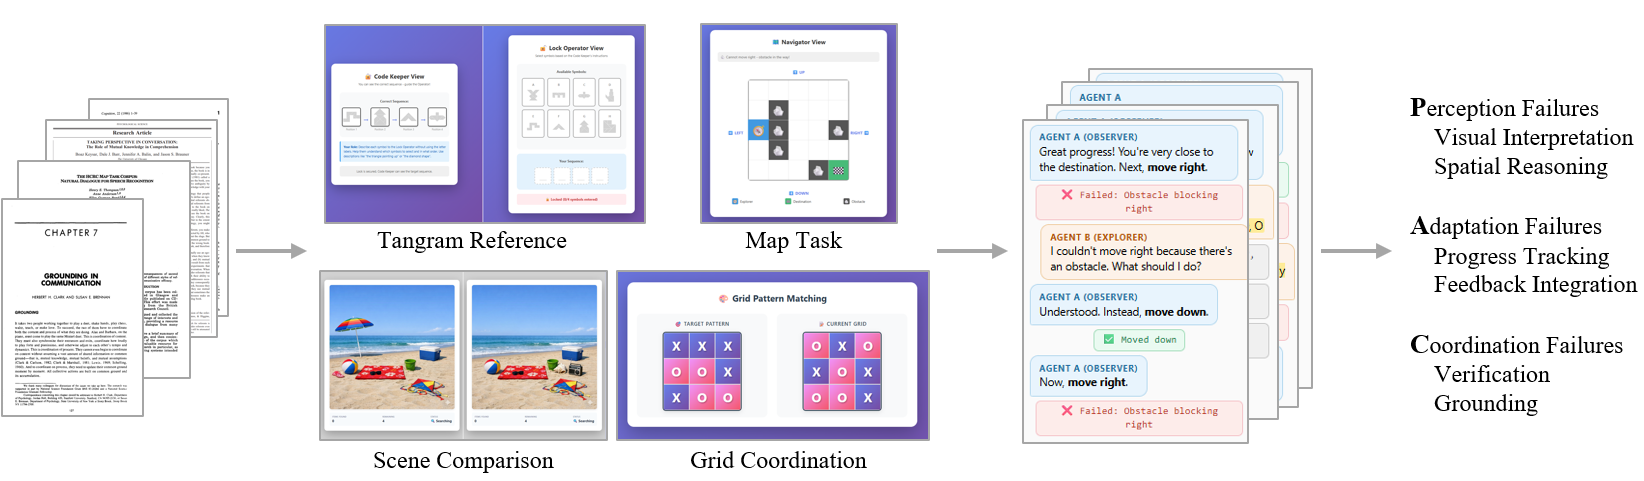
PARLEY 预印本提供四类不对称协作谜题,评估大模型智能体如何交换信息、协调动作及理解对方视角。研究使用 GPT-4o 智能体配对完成测试。
在 400 段对话中,任务平均成功率为 60.5%,不同任务的结果相差较大。团队把失败归为感知、适应和协调等类型,其中反复忽略外部反馈是一个突出问题。
另一组 200 次测试采用按失败类型设计的干预,平均成功率达到 70.5%。论文据此讨论如何通过任务反馈改进协作,结论仍对应所选模型与谜题环境。
来源:arXiv 原文。
图片来源:论文作者 / arXiv。