
 研究

OpenAI 首席科学家 Jakub Pachocki 在 11 月 22 日发表文章,公开了团队从 GPT‑3.5 起追踪的一项指标,并建议模型开发者探索在共同数据上比较困惑度。
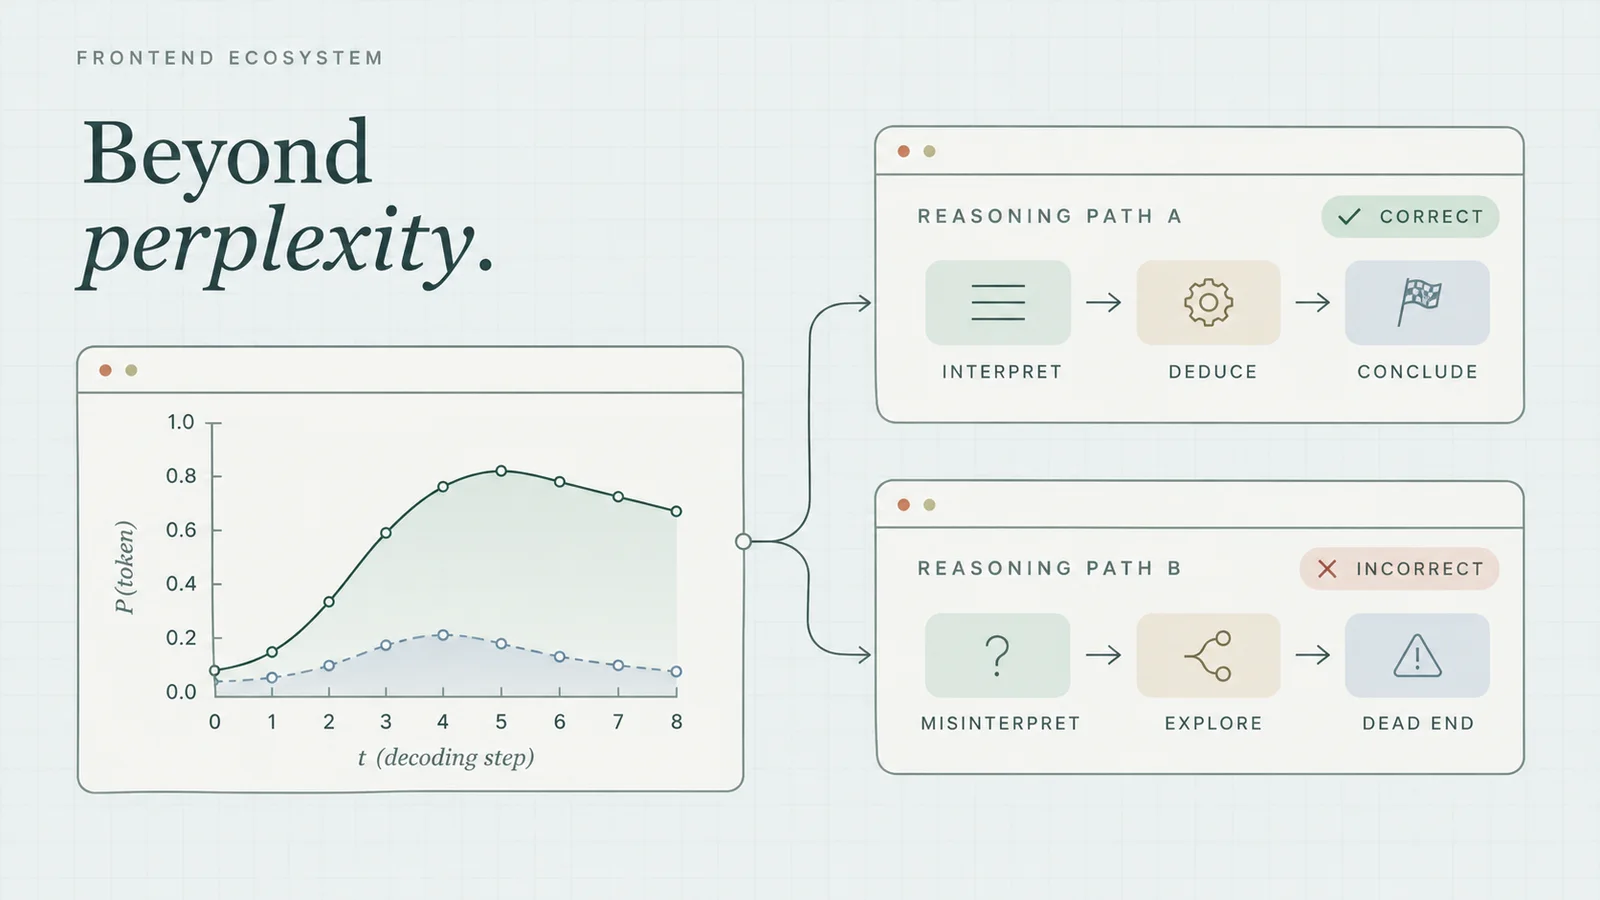
困惑度衡量模型对留出文本中下一个词元的预测能力。OpenAI 展示的曲线使用其内部代码库的固定快照,这样可以在同一批样本上观察不同代模型的变化。外部团队若要复现这种比较,需要先约定数据与度量方式。
Pachocki 也给出了选错测试集的例子。GPT‑2 和 GPT‑3 的训练数据与后来的模型不同,只用代码预测成绩衡量早期模型,会低估它们在其他文本上的能力。这篇文章提出了一种比较办法,行业共享标准仍是作者的倡议。
来源原文。插画由 GETAI 制作。