 应用

Together AI 在 11 月 20 日宣布,通过其服务可以调用 Qwen3 TTS。开发者可选九种预设音色,并用自然语言指定一句话要说得轻快、兴奋还是平静。同一音色可以覆盖包括中文、英语、日语在内的十种语言,适合需要在不同市场保持声音一致的产品。
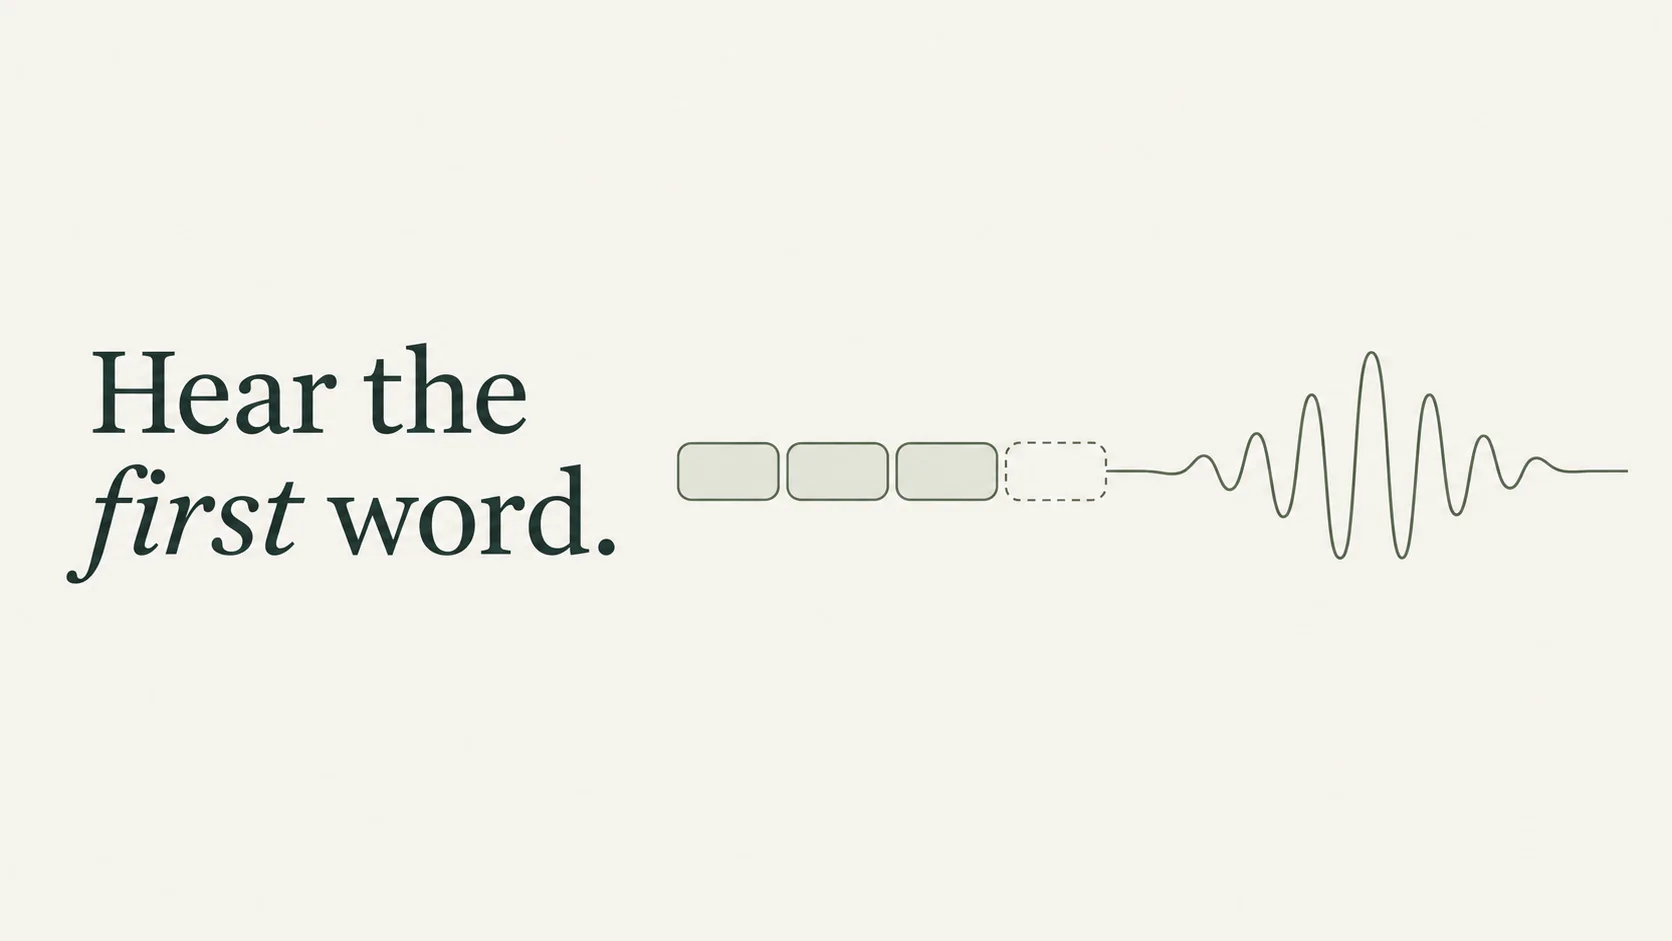
两种流式接口解决的是不同问题。文本已经齐全时,客户端可通过 HTTP 提交完整内容,在服务器逐段返回音频时开始播放。如果上游模型仍在写回答,客户端则可保持一条 WebSocket 连接,分次发送文本,由服务在收齐句子后合成。这使语音助手可以在整段回答写完前就开始出声。
Together AI 给出的最快首段音频时间是 97 毫秒,衡量的是流式请求何时开始返回声音。它没有给出所有请求的典型延迟,也没有把上游生成文字、网络传输和本地播放合成一个端到端数字。官方示例使用 24 kHz、16 位单声道 PCM,可以直接观察每批音频到达的时间。
配图为 GETAI 原创 AI 主题插画。