
 研究

使用语言模型给回答评分时,一个实际问题是,不同题目往往由不同的人打分,难以找到一组从头评到尾的标注员。Nagham Omar 等人 11 月 19 日公布 AltRA-Test,提出在这种稀疏标注条件下,检验模型能否替代评审组中的一个人。
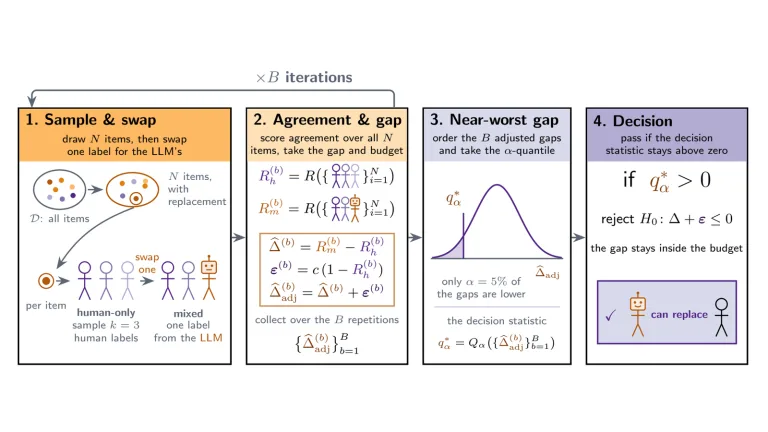
研究者重新抽取题目,并从每道题已有的人工打分中抽出若干份。先计算全人工小组的一致性,再把其中一份换成模型打分,计算混合小组的一致性。如果成对比较表明一致性未下降到预设界限之外,检验才支持在该任务中替换一名标注员。
作者在模拟数据及 20 个文本、图像、音频和视频数据集上测试了 18 款模型与五种提示方式。在真实数据实验中,约半数设置通过检验,差异主要与任务有关。这一指标衡量模型能否保留人工标注者共有的判断信号;遇到标注者共同判断错误的问题,仍需其他依据核实。
配图为 Nagham Omar 等 的图 1。封面等比缩放并留白。CC BY 4.0 许可。