开发动态arXiv

RoboScript 让机器人在上下文中学习操作
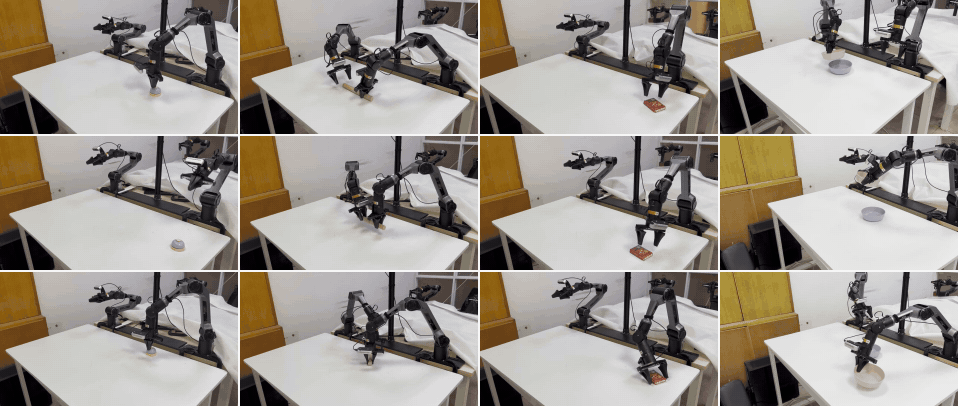
11 月 9 日公开的预印本提出 World In-Context Learning,作者来自华中科技大学与 ArcheOne AI,配套框架名为 RoboScript。方法从一次示范出发,在模拟环境里练习,把反馈写进任务记忆,而不是更新基础模型权重。
阅读全文查看来源为 arXiv 的资讯与动态,保留原文入口和发布时间。
11 月 9 日公开的预印本提出 World In-Context Learning,作者来自华中科技大学与 ArcheOne AI,配套框架名为 RoboScript。方法从一次示范出发,在模拟环境里练习,把反馈写进任务记忆,而不是更新基础模型权重。
阅读全文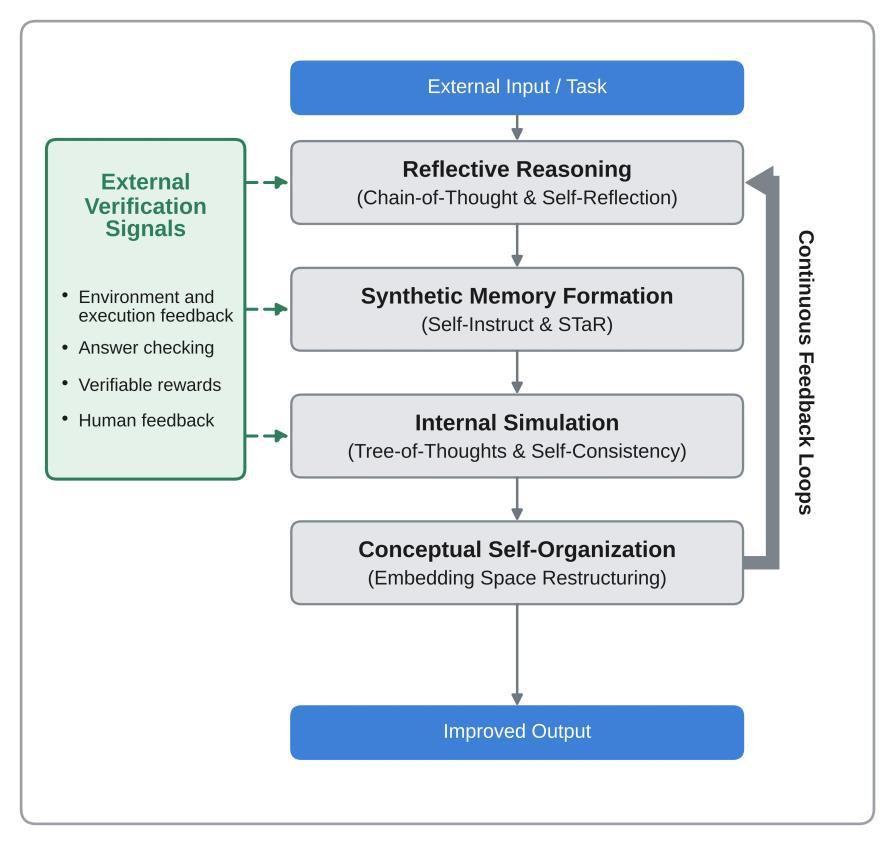
一篇 11 月 10 日提交的论文尝试梳理大模型在没有新外部信息时,如何通过解释、反思和内部推演产生新的任务见解。作者提出一个认知框架,将相关方法分为反思推理、合成记忆、内部模拟和概念自组织四类。
阅读全文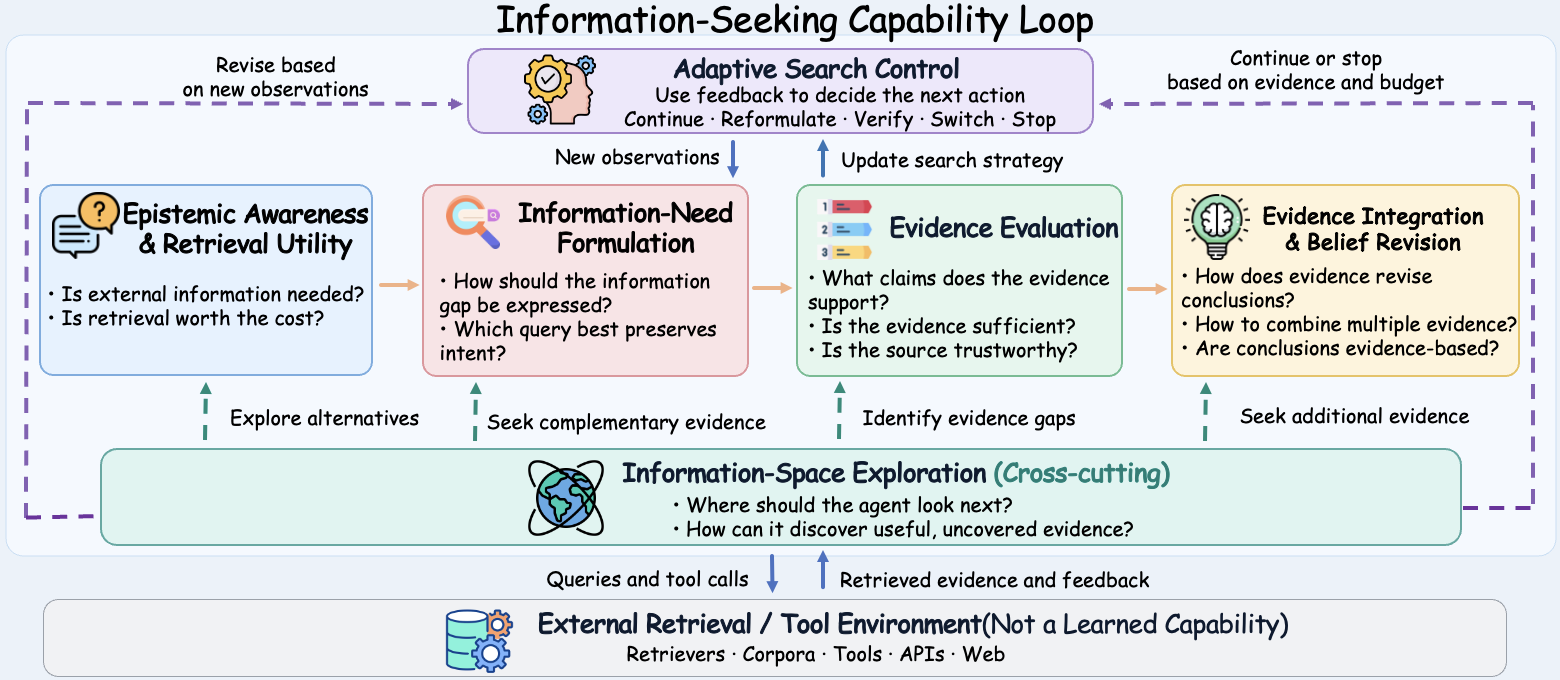
研究者 11 月 10 日提交一篇信息检索综述,关注大模型如何决定何时补充资料、去哪里搜索,以及怎样判断和使用搜索结果。论文把这些行为整理为六类相互关联的信息获取能力。
阅读全文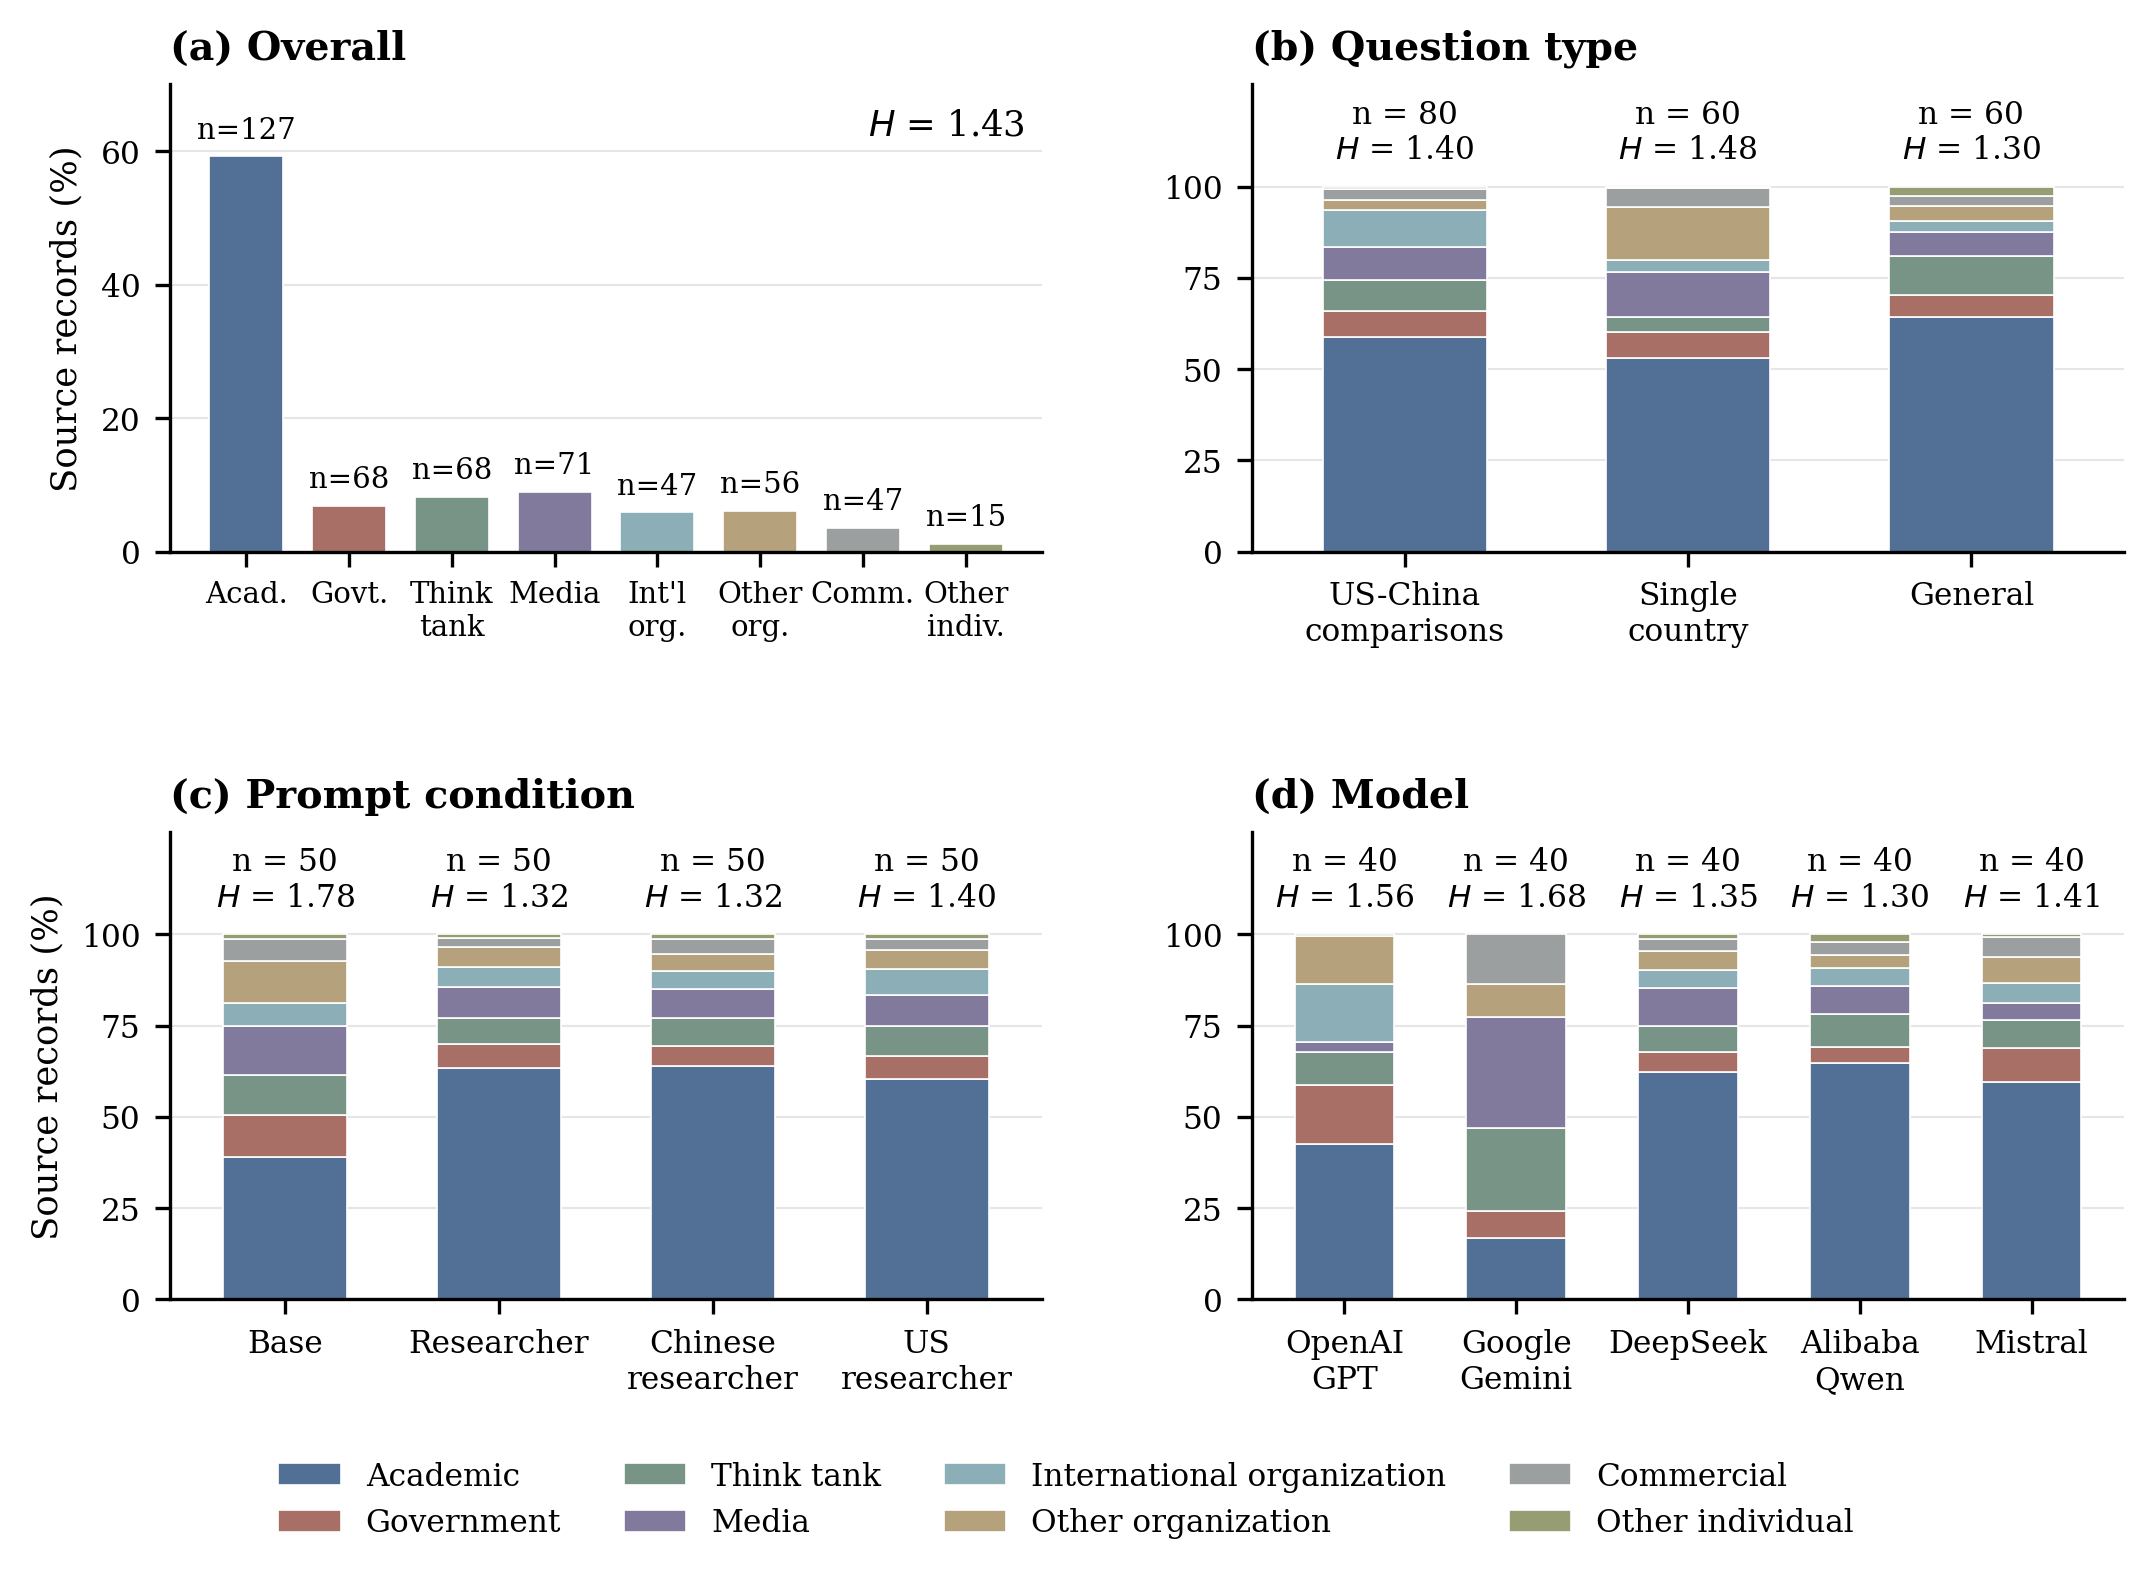
一项 11 月 10 日提交的研究,比较五个大模型回答中美相关社科问题时的表现。研究者选择两个美国开发模型、两个中国开发模型和一个欧洲开发模型,并改变问题类型及用户所扮演的研究者身份。
阅读全文共 190 篇
11 月 9 日公开的预印本提出 World In-Context Learning,作者来自华中科技大学与 ArcheOne AI,配套框架名为 RoboScript。方法从一次示范出发,在模拟环境里练习,把反馈写进任务记忆,而不是更新基础模型权重。
一篇 11 月 10 日提交的论文尝试梳理大模型在没有新外部信息时,如何通过解释、反思和内部推演产生新的任务见解。作者提出一个认知框架,将相关方法分为反思推理、合成记忆、内部模拟和概念自组织四类。
研究者 11 月 10 日提交一篇信息检索综述,关注大模型如何决定何时补充资料、去哪里搜索,以及怎样判断和使用搜索结果。论文把这些行为整理为六类相互关联的信息获取能力。
一项 11 月 10 日提交的研究,比较五个大模型回答中美相关社科问题时的表现。研究者选择两个美国开发模型、两个中国开发模型和一个欧洲开发模型,并改变问题类型及用户所扮演的研究者身份。
ARE-bench 研究于 11 月 10 日提交,关注研究智能体能否沿着已有项目继续工作。它保留真实会话中的要求、旧版本、未完成文件和失败尝试,而不是先提供一个清理好的理想工作区。
AutoScaffold 研究于 11 月 10 日提交,让冻结教师模型定期查看学生模型的训练经历,再生成任务策略或针对难题的提示。提示随着训练进度调整,正式评估时会移除。
11 月 10 日提交的 AVCC 研究,为对话智能体预测“接下来谁会说话”建立评测。数据来自单台固定摄像头和麦克风录制的 31 小时双人、三人在线交谈,更接近部分社交机器人的传感器条件。
研究者 11 月 10 日提交实验,将 Qwen3.8-27B 改为一个字节对应一个 Token 的模型。团队把词表从 248320 个条目缩小到 384 个,保留其他初始权重,再用模型自生成数据和百科文本继续训练。
11 月 10 日提交的 CAMP-II 研究,让智能体直接通过常规文件操作管理长任务记忆。系统提供 Bash 和持续保留的工作区,模型需要自行决定何时创建、修改、搜索和重读文件。
11 月 10 日提交的 Contrastive Discovery 研究,要求科学智能体为同一个问题提出一组相互竞争的解释,再用实验结果更新判断,避免只知道一个猜想不成立,却无法继续寻找答案。
研究者 11 月 10 日提交 Earlybird 流式语音识别模型,参数量为 2900 万。它在单词尚未完全说完时预测当前词,并给出后续词语的猜测和置信度,面向更低延迟的语音助手。
11 月 10 日提交的 EngineAgent 研究,把手机端新模型适配拆成跨层修改和设备验证流程。系统先整理推理引擎、算子与硬件后端之间的依赖,再让构建智能体修改实现、审查智能体检查遗漏。
MMDM 研究于 11 月 10 日提交,为直接输出选项概率的决策模型建立测试。基准包含 5448 道题、十六类任务,覆盖工具选择、状态跟踪、偏好判断和评分等场景。
研究者 11 月 10 日提交 NumPrint,探索模型能否通过一串数字暴露自身特征。基准收集 51 个模型的 5036 份回答,提示模型一次给出 294 个指定范围内的整数。
11 月 10 日提交的 PASE 研究,为智能体技能关联可执行程序,把操作流程与自然语言说明分开维护。任务失败后,系统可以针对程序片段打补丁,而不必反复重写整份技能文档。
11 月 10 日提交的 Synapse-Control 研究尝试降低智能体复用经验时的额外成本:不再每次调用大模型诊断失败,而是先用规则筛选建议,再由 17 亿参数分类器判断哪些建议值得送给执行模型。
11 月 10 日提交的 TERM 研究,提出在推理过程中根据注意力熵变化调整模型残差更新,尝试兼顾越狱防御与正常请求的可用性,而不预先指定一条固定的安全方向。
11 月 10 日提交的一项研究,把 AI 回答评估的视角转向用户后续发言:即使回答通顺,用户也可能觉得没有解决问题。研究团队利用带有自报不满标签的对话,测试这些信号能否从文本中识别。
11 月 10 日提交的 Walrus 技术报告介绍了统一语音与音频模型,覆盖语音识别、语音翻译、语音合成、情绪识别和音频描述。模型参数量为 80 亿,采用从 Gemma 4 初始化的解码器骨干。
比较记忆检索、证据保真与长期对话,提出无需再训练的混合检索方法。
把具体任务与目标手机一起纳入优化,比较微调、量化和真实设备运行表现。
先把文档渲染为图片,再检索与问题相关的视觉信息,减少传给语言模型的内容。
让视觉语言模型在看清局部细节和保留全局信息之间动态选择。
把故障、物理量变化和传感器信息连成知识链,供模型逐项推理。
11 月 9 日公开的预印本提出 World In-Context Learning,作者来自华中科技大学与 ArcheOne AI,配套框架名为 RoboScript。方法从一次示范出发,在模拟环境里练习,把反馈写进任务记忆,而不是更新基础模型权重。