
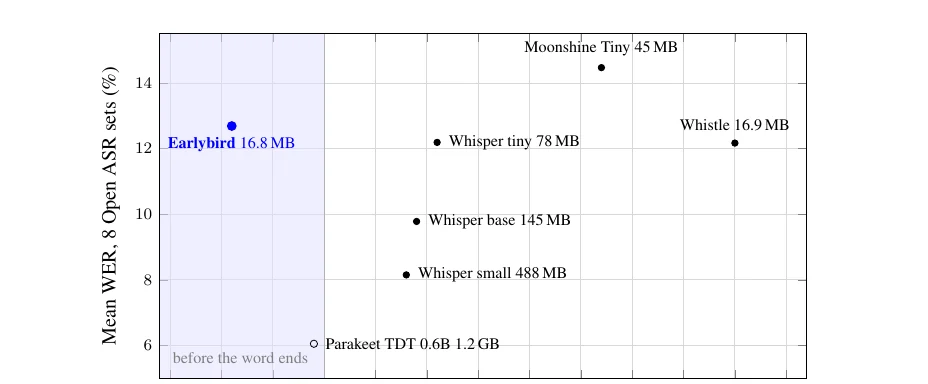
研究者 11 月 10 日提交 Earlybird 流式语音识别模型,参数量为 2900 万。它在单词尚未完全说完时预测当前词,并给出后续词语的猜测和置信度,面向更低延迟的语音助手。
在干净有声读物测试中,模型正确识别单词的中位时刻比说话者结束该词早约 90 毫秒;69% 的单词可在说完前被正确预测。团队还在演讲、财报电话会议等六组数据上比较输出时机。
预测不等于已听到完整内容,错误猜测仍可能发生。论文报告了未说完词语的置信度校准结果;实际应用需要决定何时等待更多音频,不能把提前预测直接当成确认指令。
来源:arXiv 原文。
图片来源:论文作者 / arXiv。