
Draw Things 团队 11 月 11 日分享 Local Code 的开发复盘,解释本地大模型为什么会在处理输入,也就是预填充阶段遇到性能瓶颈。团队最初希望把扩散模型引擎的优化经验直接用于大模型,实际开发中发现两者存在重要差异。
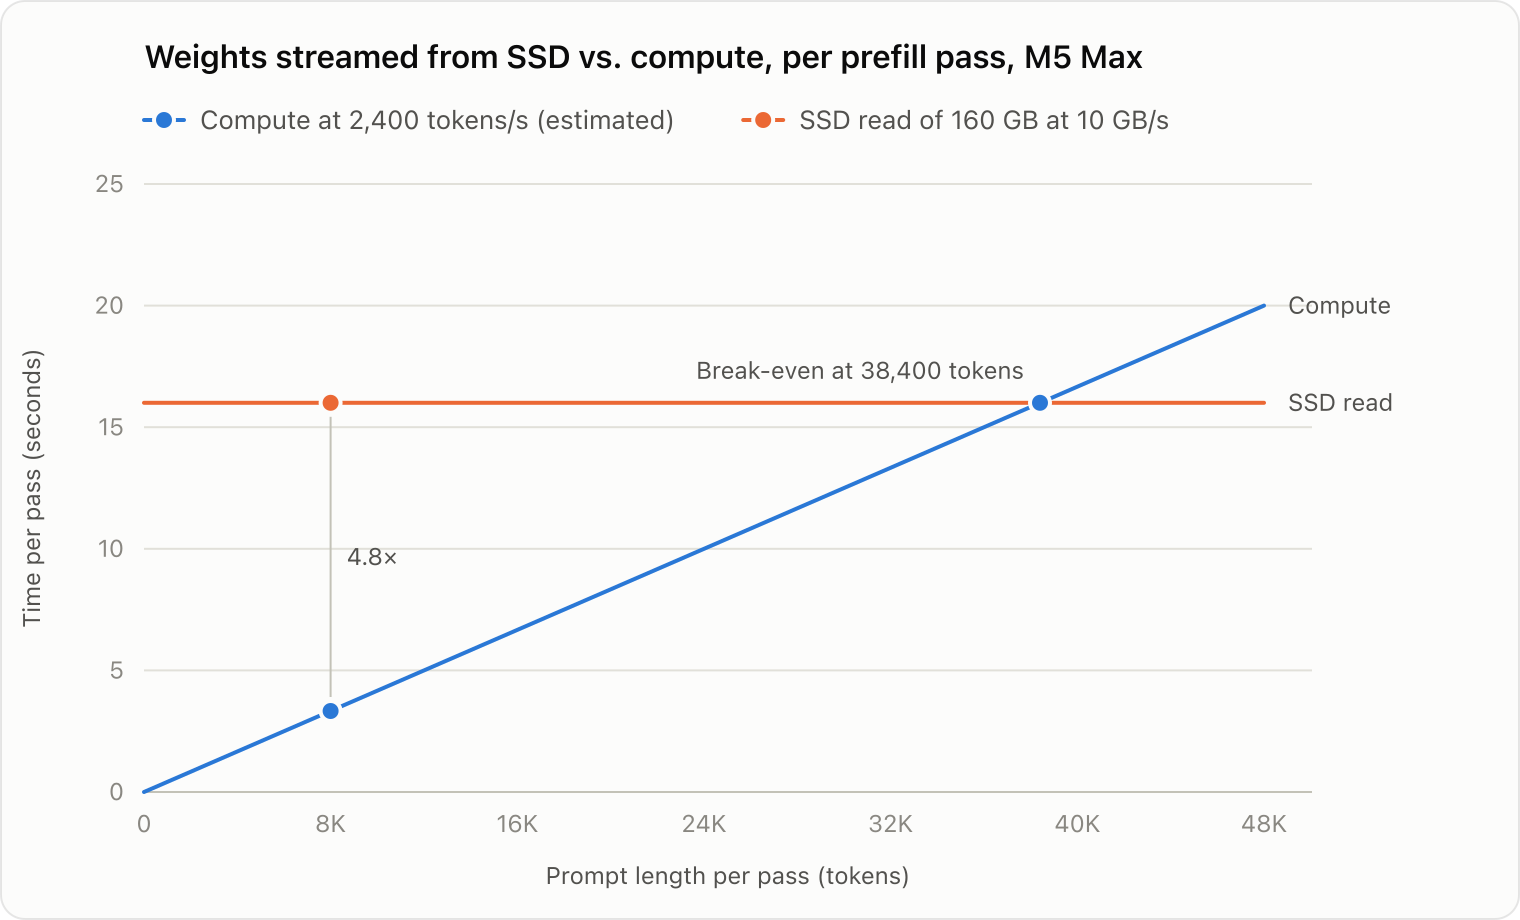
一个问题是从 SSD 流式加载模型权重。提示词足够长时,数据读取可以与大量计算重叠;但在较短的多轮对话里,反复加载权重的成本可能无法被计算掩盖。团队给出的配置算例中,约八千 Token 的常见输入无法充分摊薄完整权重的读取时间。
文章还比较了混合专家模型按需读取专家与异步读取整层的取舍。它是一篇开发者工程复盘,而不是发布新模型或通用加速方案,具体性能数字对应文中列出的设备和配置。
图片来源:Draw Things 工程团队。