
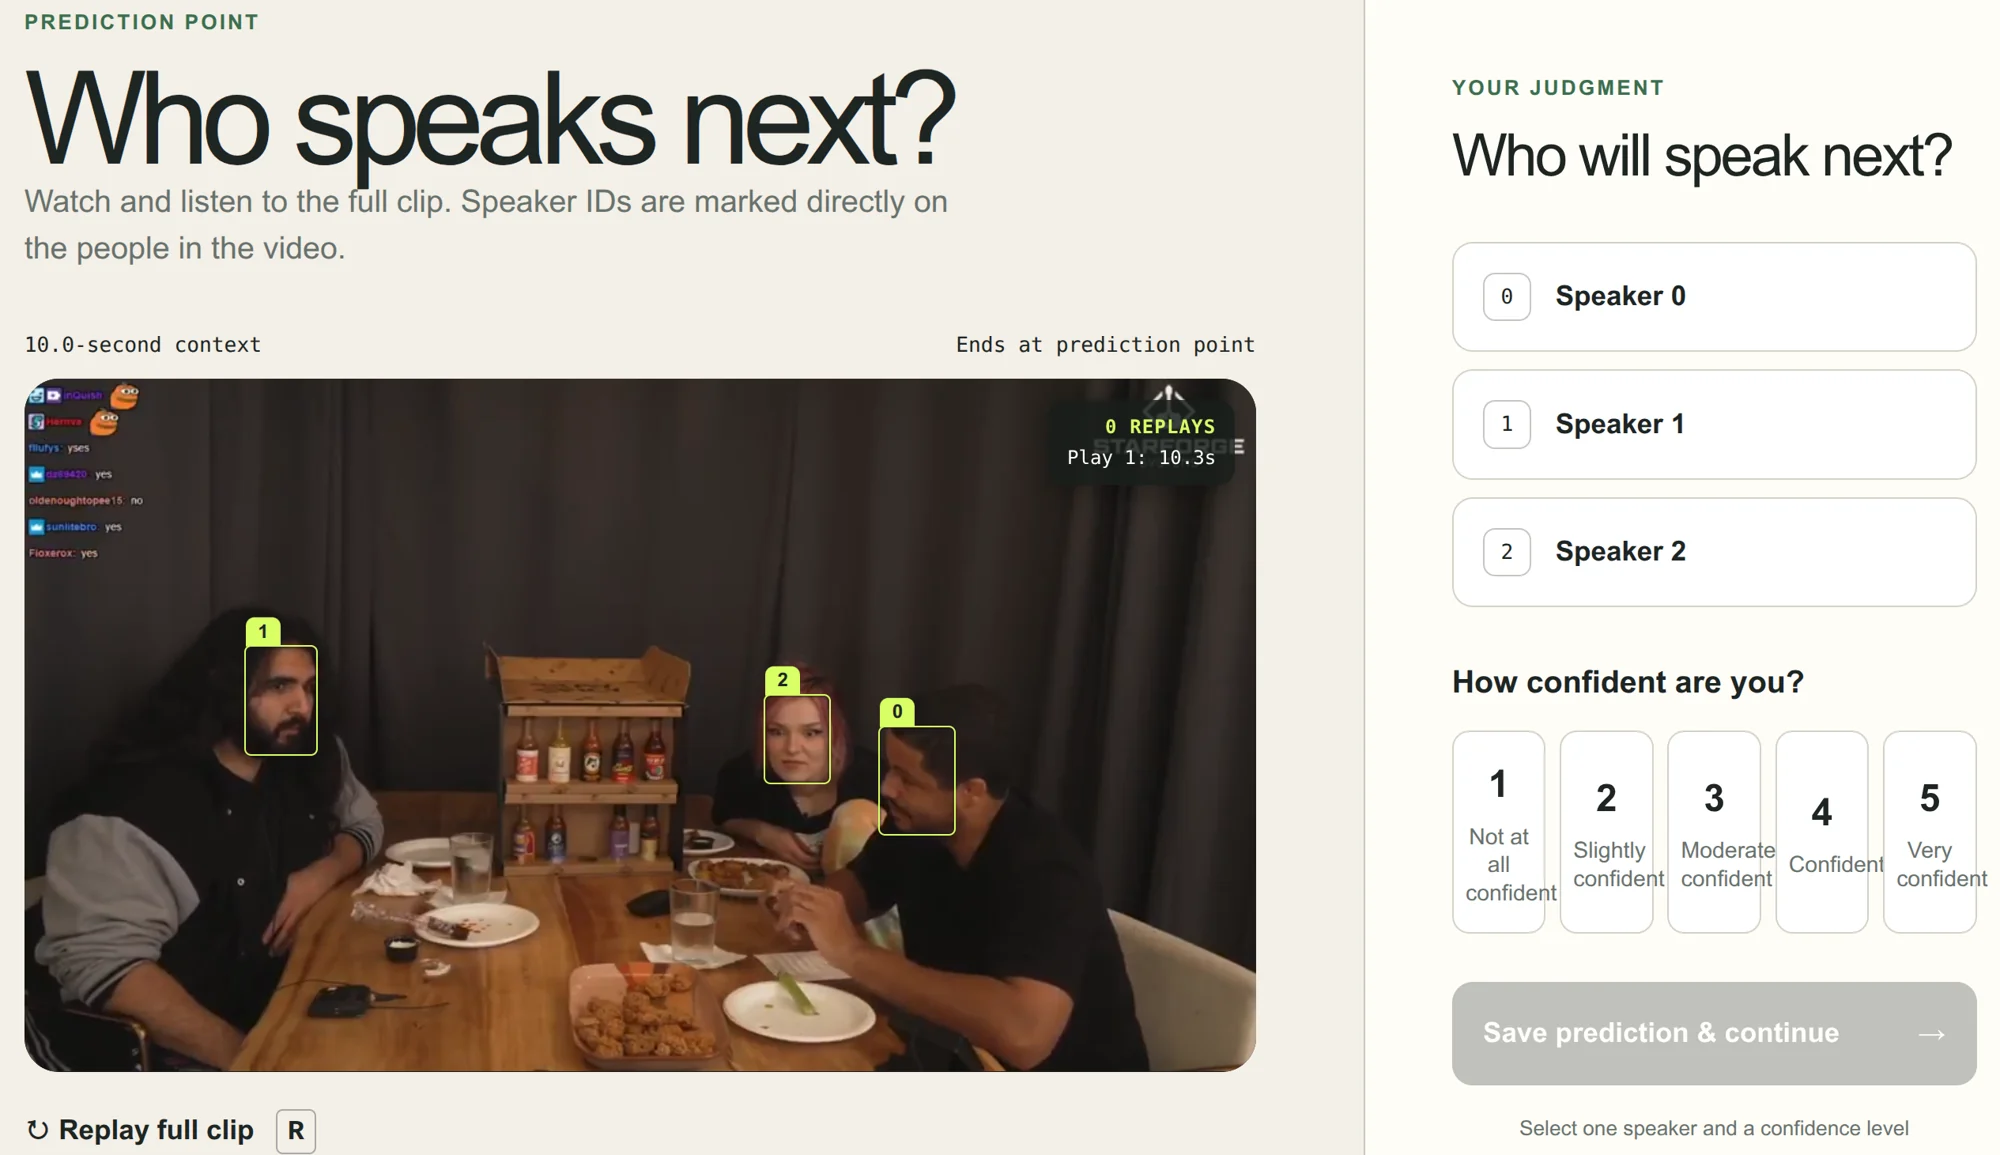
11 月 10 日提交的 AVCC 研究,为对话智能体预测“接下来谁会说话”建立评测。数据来自单台固定摄像头和麦克风录制的 31 小时双人、三人在线交谈,更接近部分社交机器人的传感器条件。
团队增加了与训练说话者分离的测试视频,在共同沉默间隙设置 865 个继续发言和 865 个换人事件,并提供逐词对齐转写和人类参考结果。
作者比较了纯音频与多模态模型,并开放标签、转写及复现脚本。该基准用于研究轮次预测,不是已经可以在所有会议里无误插话的成品助手。
来源:arXiv 原文。
图片来源:论文作者 / arXiv。