
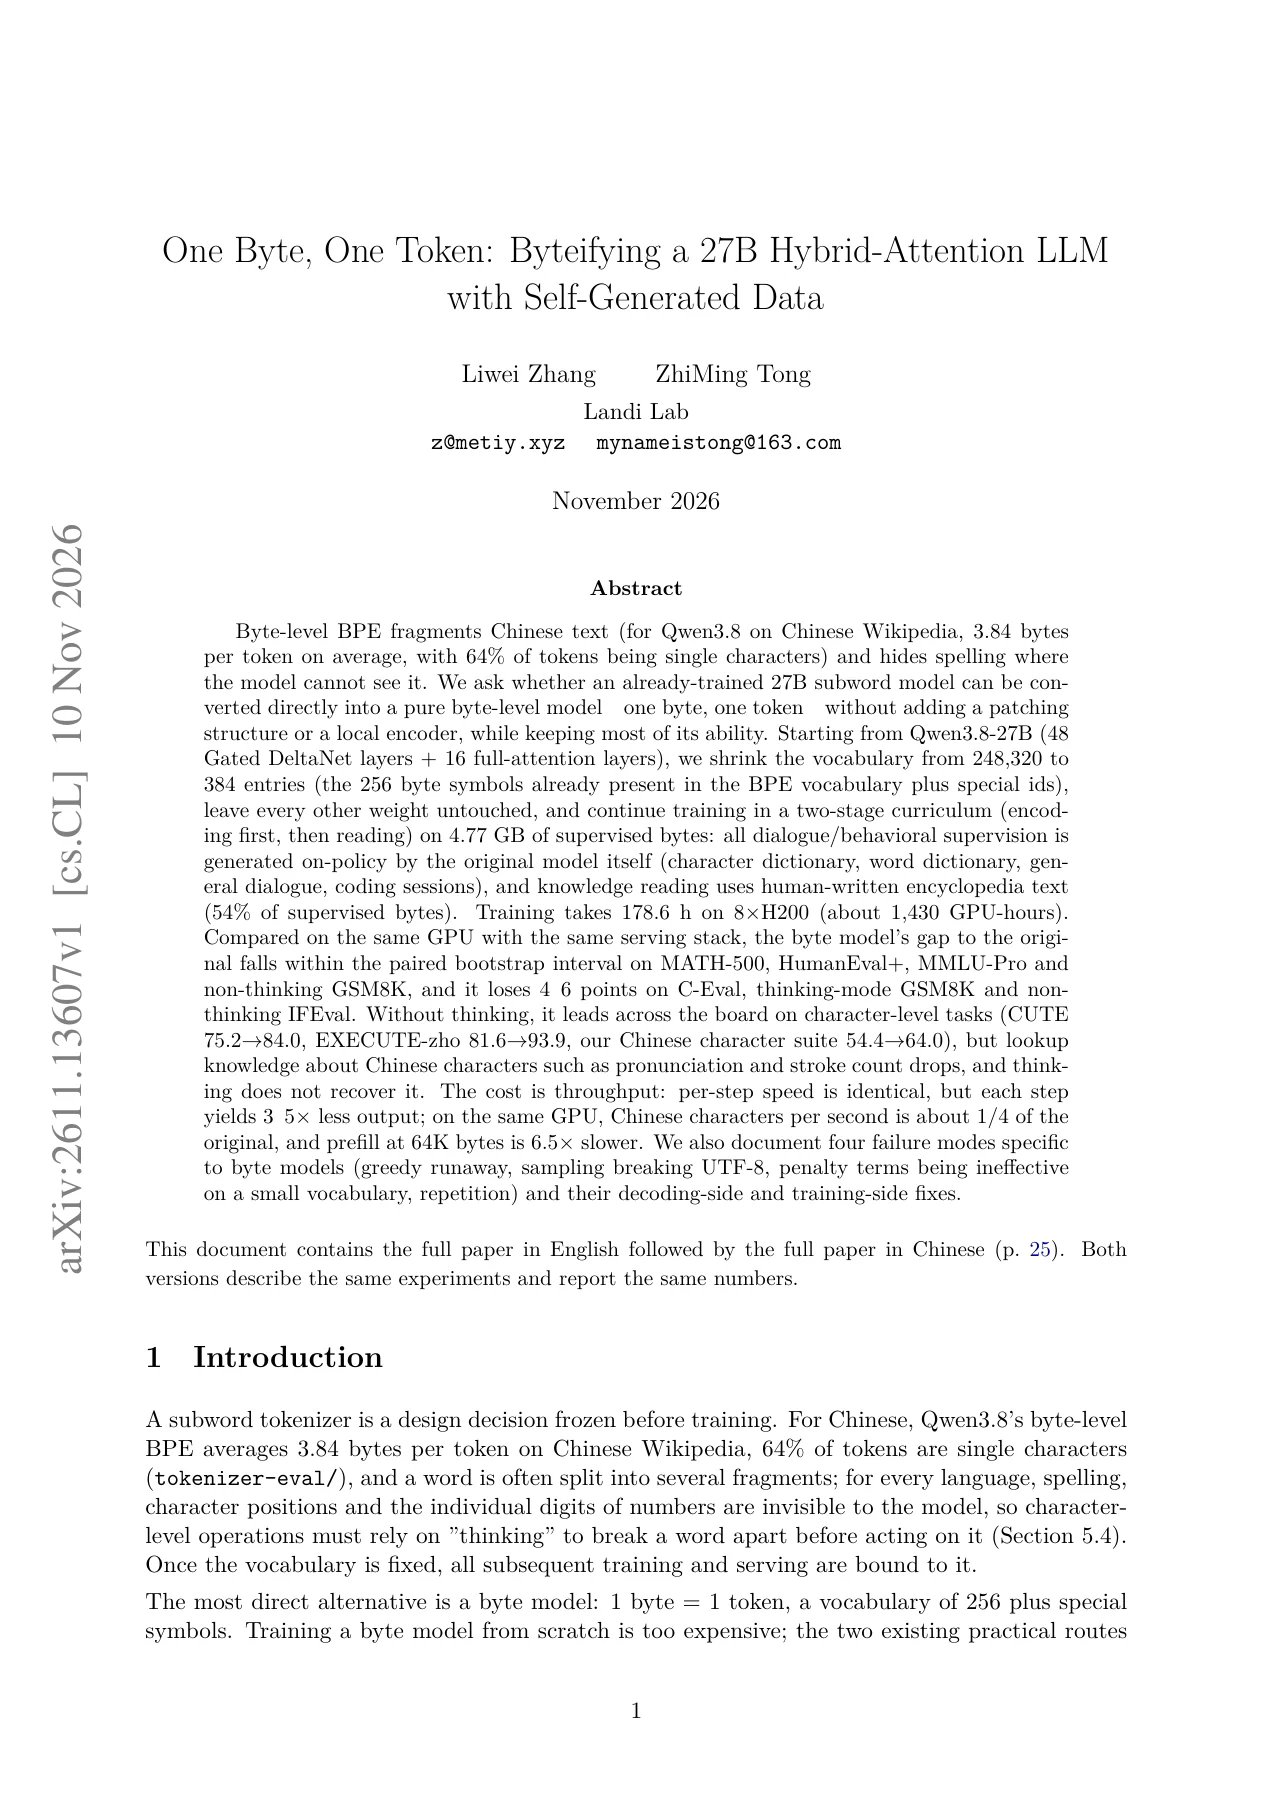
研究者 11 月 10 日提交实验,将 Qwen3.8-27B 改为一个字节对应一个 Token 的模型。团队把词表从 248320 个条目缩小到 384 个,保留其他初始权重,再用模型自生成数据和百科文本继续训练。
论文报告,转换后的模型在多项字符处理任务中表现更好,部分数学和编程基准与原模型的差距落在统计区间内,但也有基准下降 4 至 6 分。训练使用八张 H200,耗时约 178.6 小时。
这种转换并没有带来更快输出:中文字符吞吐量约为原来的四分之一,长输入预填充也明显变慢。论文同时记录了 UTF-8、重复生成等问题,展示了字符能力与推理效率之间的实际取舍。
来源:arXiv 原文。
图片来源:论文作者 / arXiv。