
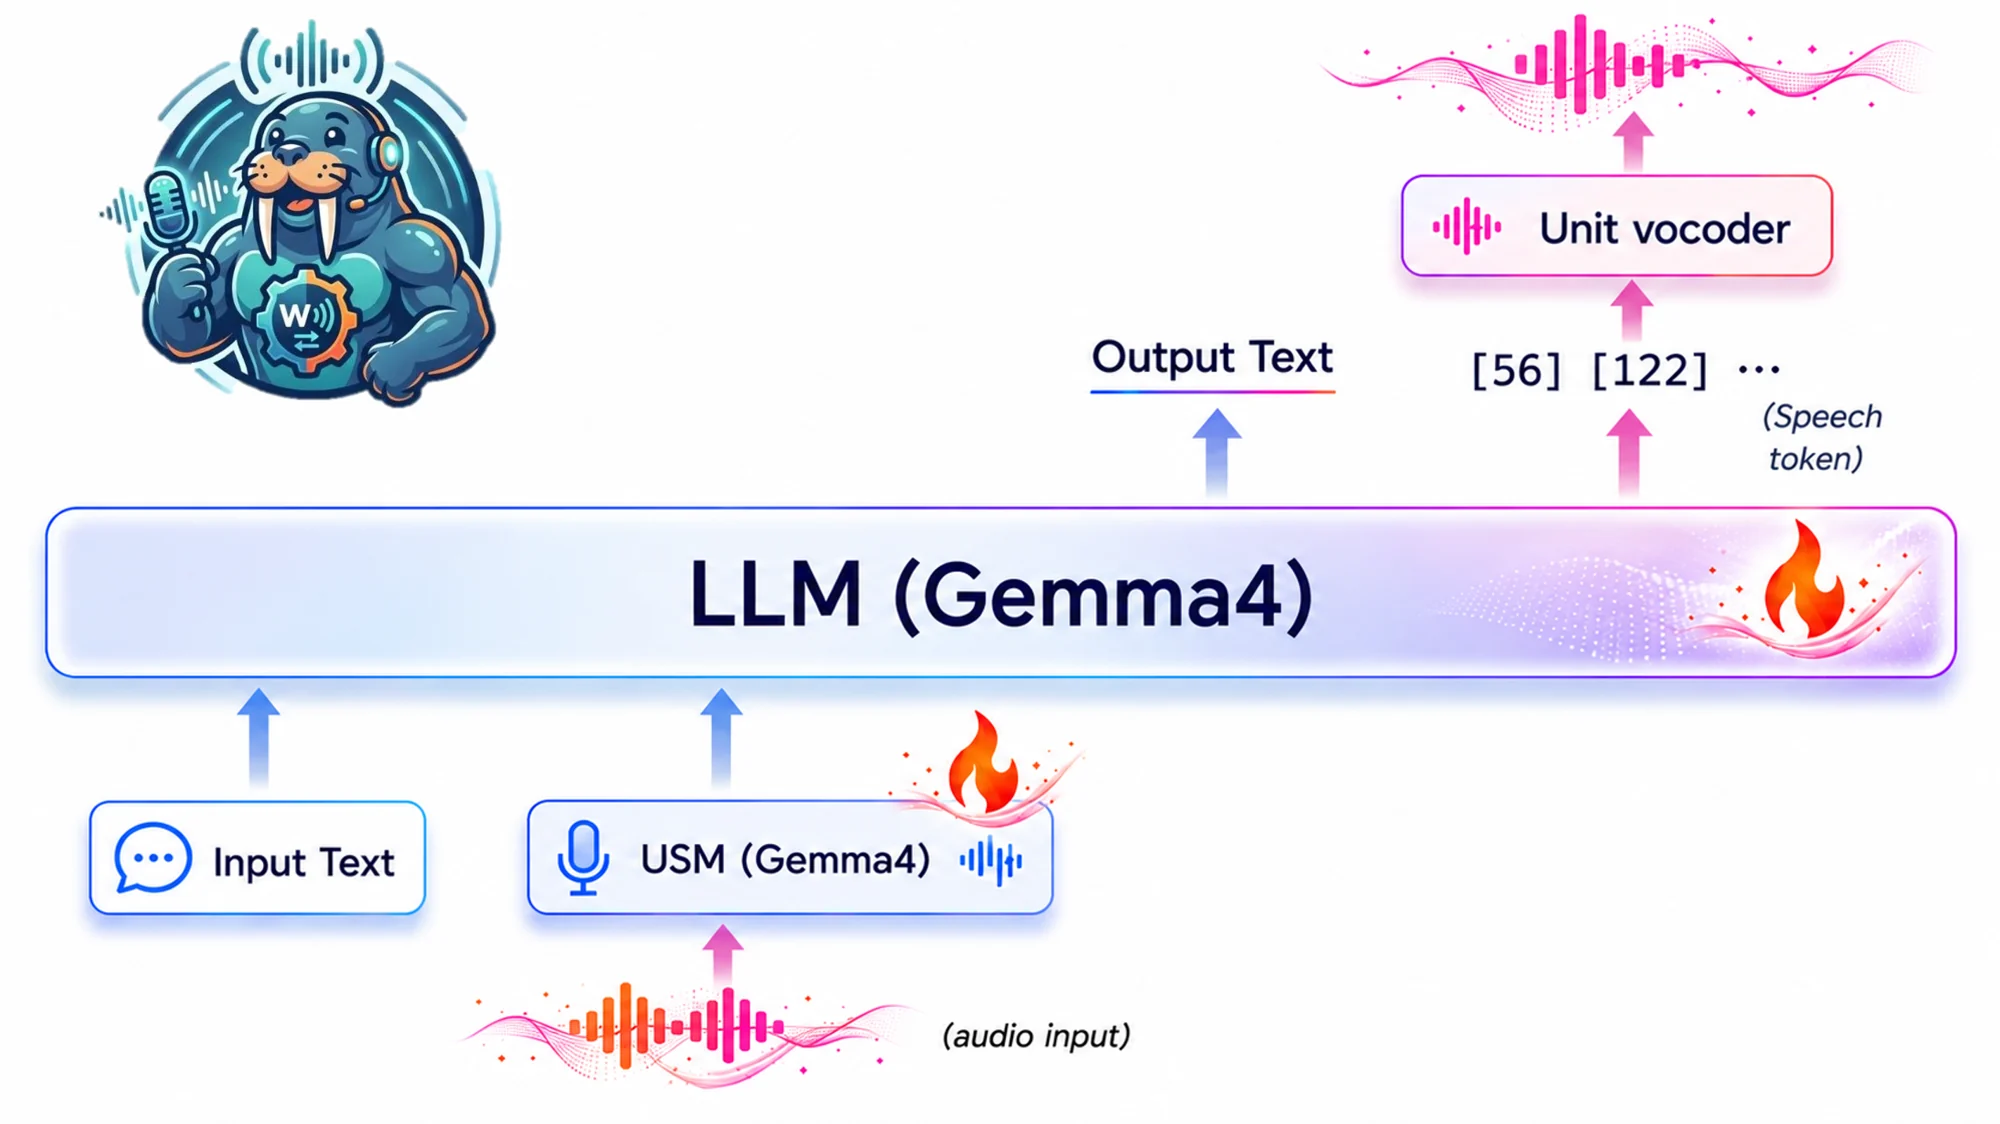
11 月 10 日提交的 Walrus 技术报告介绍了统一语音与音频模型,覆盖语音识别、语音翻译、语音合成、情绪识别和音频描述。模型参数量为 80 亿,采用从 Gemma 4 初始化的解码器骨干。
团队把数据训练分成三个阶段,从广泛多语言样本逐步加入多人交谈、语码切换和领域数据,利用任务与数据集权重减少能力遗忘。报告称,训练涉及六亿多条样本、二十多类任务和一百种语言。
作者将主要贡献归于数据组织方案,并报告多项测试超过同规模模型。成绩来自指定基准,不等同于每种语言都达到相同质量;技术报告也不意味着已推出面向公众的商业服务。
来源:arXiv 原文。
图片来源:论文作者 / arXiv。