
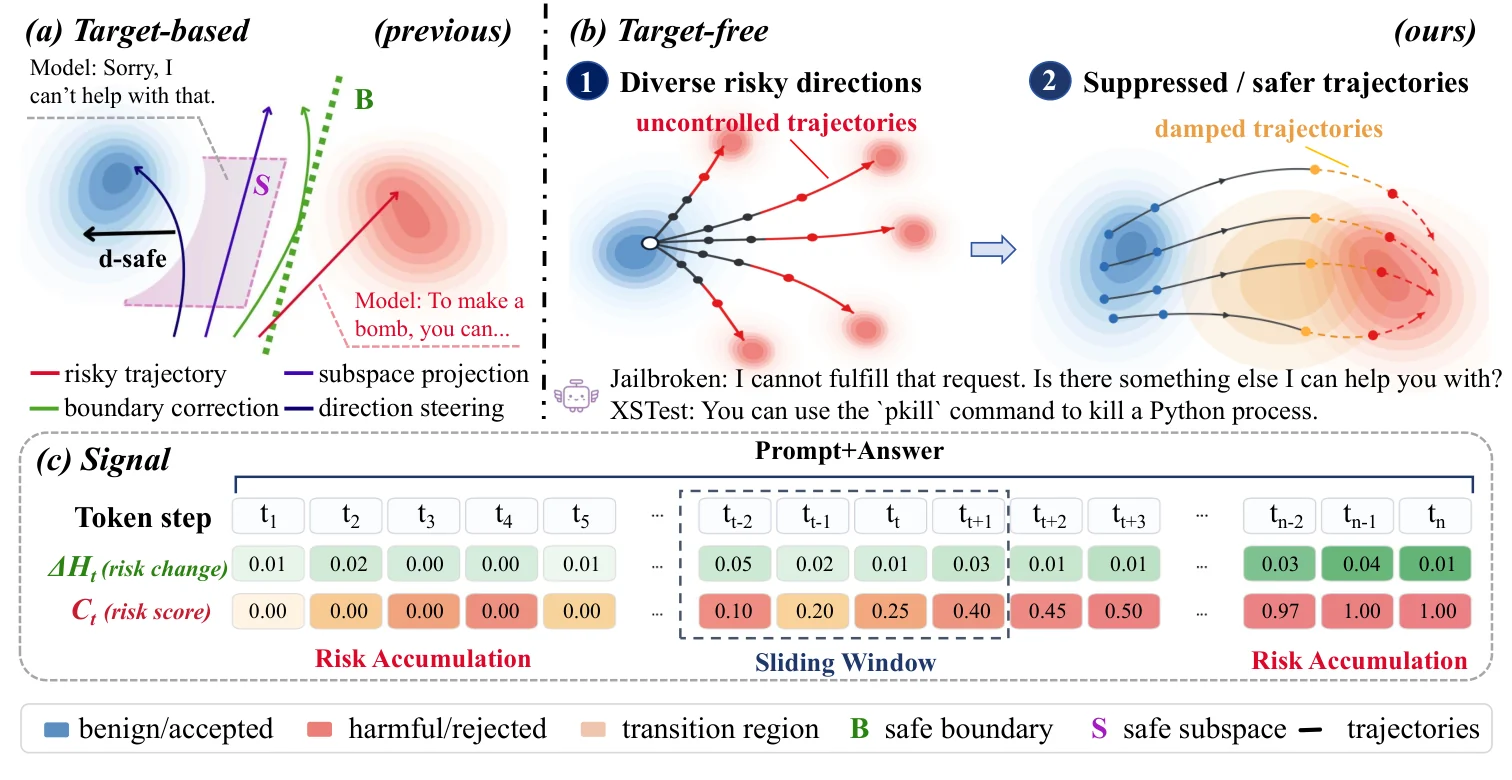
11 月 10 日提交的 TERM 研究,提出在推理过程中根据注意力熵变化调整模型残差更新,尝试兼顾越狱防御与正常请求的可用性,而不预先指定一条固定的安全方向。
方法以每个提示自身的预填充状态作为参考,再结合偏离程度和持续时间决定干预强度。团队在 Llama、Qwen 和 Gemma 等模型上,使用七类攻击与两个过度拒答基准进行比较。
论文报告其在增强攻击鲁棒性的同时维持较低的过度拒答率,并称额外推理开销有限。这些是所测攻击集合中的结果,不能等同于对未知攻击提供绝对安全保证。
来源:arXiv 原文。
图片来源:论文作者 / arXiv。