
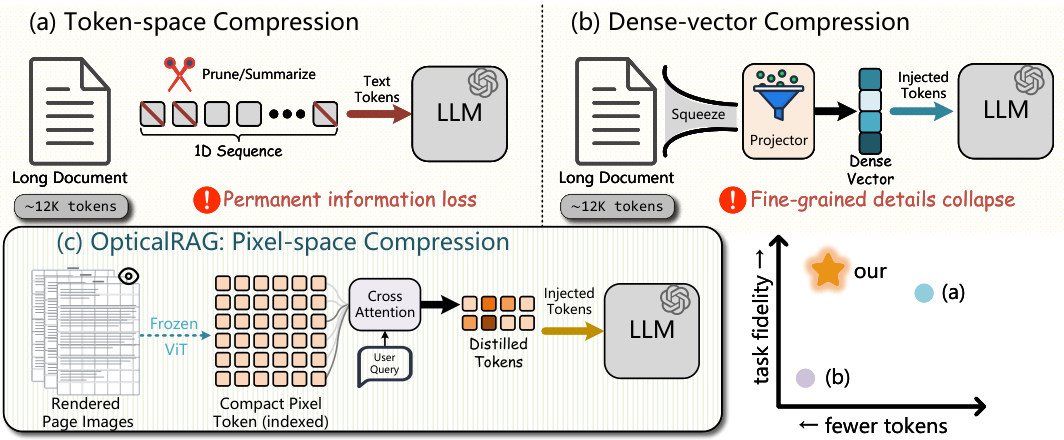
OpticalRAG 预印本于 11 月 10 日提交,探索检索增强生成中的另一条压缩路线:把文档作为页面图像处理,而不是只压缩文字。
系统使用冻结的视觉编码器表示页面,将文字查询映射到视觉空间,检索相关信息后,再通过轻量压缩模块生成与问题有关的前缀表示。
作者在 LongBench-v2、BAMBOO 和 LooGLE-v2 上报告了只注入 16 个压缩 Token 的实验。这个数值指传入后端语言模型的表示,不包括文档编码、索引与检索的全部计算成本。
来源:arXiv 原文。
图片来源:论文作者 / arXiv。