
ARE-bench 研究于 11 月 10 日提交,关注研究智能体能否沿着已有项目继续工作。它保留真实会话中的要求、旧版本、未完成文件和失败尝试,而不是先提供一个清理好的理想工作区。
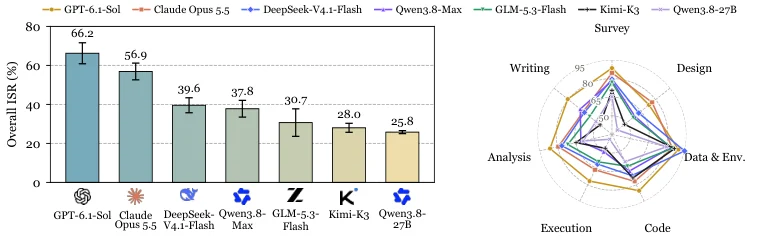
基准包含来自研究者项目的 75 项任务,覆盖七个研究阶段,共设置 1173 个二元检查项。在七个前沿模型中,表现最强者能在 66.2% 的任务上满足全部检查项。
当评估加入历史决定和已有材料约束后,部分模型的通过率明显低于只检查一般交付要求时的结果。团队希望用这一基准衡量“能否接着做完”,而不只看独立题目得分。
来源:arXiv 原文。
图片来源:论文作者 / arXiv。