
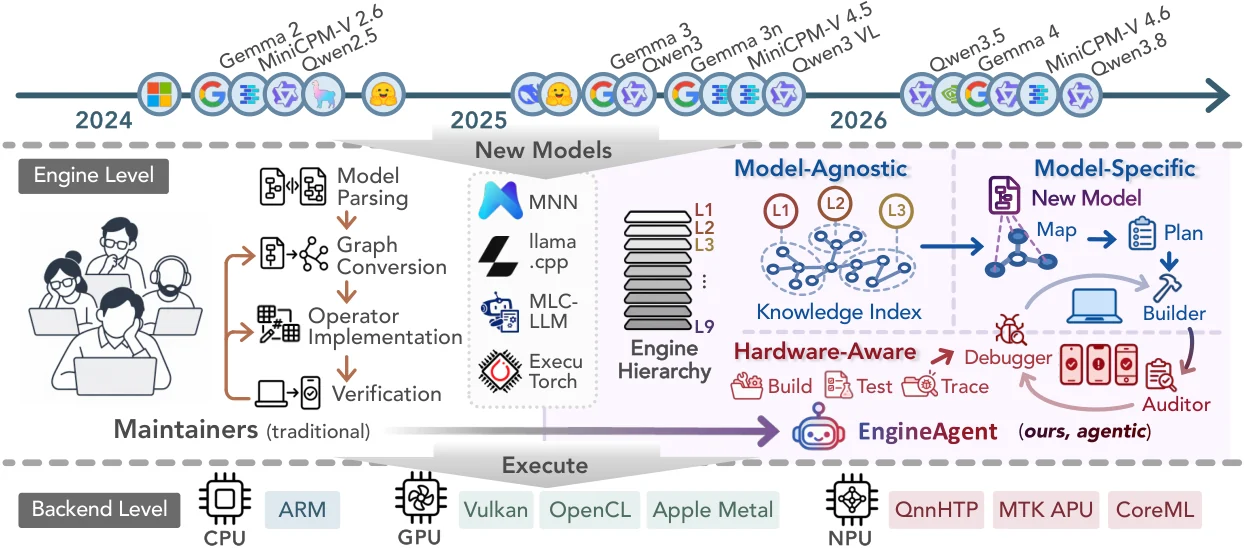
11 月 10 日提交的 EngineAgent 研究,把手机端新模型适配拆成跨层修改和设备验证流程。系统先整理推理引擎、算子与硬件后端之间的依赖,再让构建智能体修改实现、审查智能体检查遗漏。
团队在三个移动模型、四种引擎与后端组合构成的十二项任务中测试 CPU、GPU 和 NPU。论文报告,两个底层模型分别搭配该系统时,端到端成功率均为 75%,最强对照编程智能体为 33.3%。
成功标准不仅是编译通过,还要求在设备上运行,并使输出的 logits 与参考实现一致。该工作针对特定适配任务进行评测,不意味着可以自动支持任意手机和模型。
来源:arXiv 原文。
图片来源:论文作者 / arXiv。