
 研究

11 月 19 日,剑桥和牛津的研究者更新了一项关于模型内部激活干预的预印本。新版本把一种失败情况单独列出:算术题的必要信息已经给出,模型却回答说缺乏作答依据。
在同一组 100 道 GSM8K 测试题上,作者报告,未经干预的 Llama 3.1 8B Instruct 正确率为 75%,错误称信息不足的比例为 0%。在论文设定的固定强度下,DISCO-Q 的两项结果为 53% 和 11%,SKOP 为 70% 和 1%。
作者还列出了自动筛查的示例,区分模型输出中出现相关措辞和模型确实误判两种情况。上述比例来自这组任务和指定强度,不能直接推算其他模型的错误率。
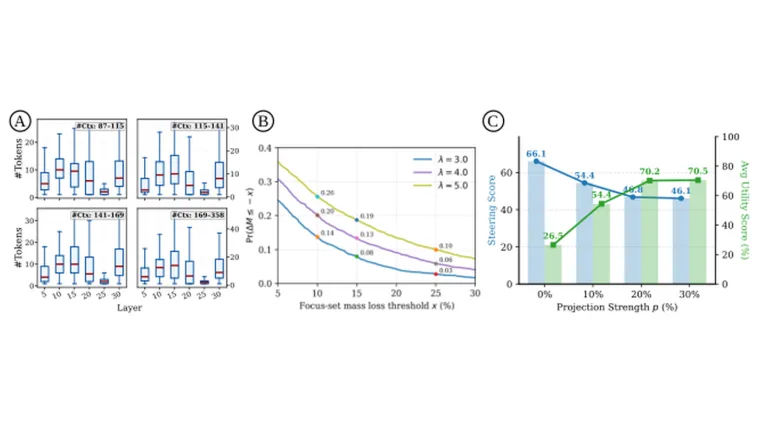
配图来自 Luo, Haoyan 等,图 2,按 CC BY 4.0 使用。