
 研究

11 月 19 日,Jongbhin Woo 等人公开一项音频语言模型研究。模型有时能认出录音里有某种声音,却报错它出现的时间。作者观察到,少数注意力头会跟随所问的声音:换一个问题,关注的位置会变;把声音移到别处,注意力也随之移动。
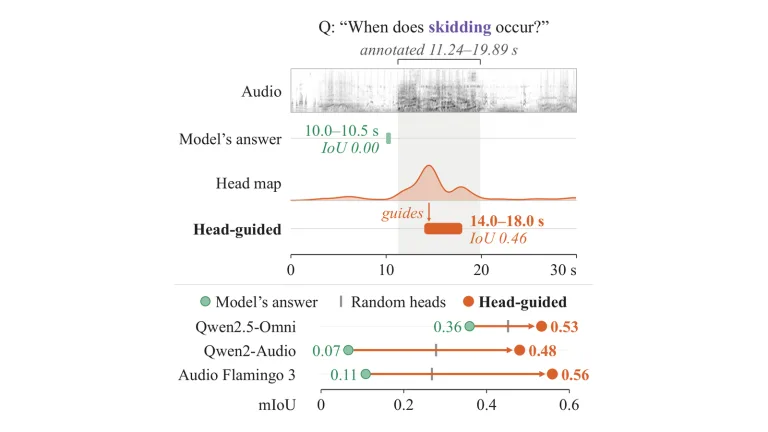
团队据此设计一种无须训练的解码办法。方法保留模型对目标声音“有或没有”的原始判断,只把这些注意力头给出的时间信息作为先验,重新排列候选时间区间。用于定位的注意力头先在开发数据上选定,换到新的录音和自由措辞的问题时沿用同一组。
在模型训练结束后才公开的录音上,三个受测模型的平均交并比从原先的 0.07 至 0.36 区间,提高到 0.48 至 0.56。交并比衡量预测时段与真实时段重叠多少,越高代表定位越接近。实验说明部分时间戳错误出现在模型组织回答的环节;研究没有声称所有声音识别错误都能靠调整时间戳解决。
配图为 Jongbhin Woo 等 的图 1。封面等比缩放并留白。CC BY 4.0 许可。