
 研究

研究团队在 arXiv 上更新了论文。扩散语言模型会分多轮补全被遮住的词元。同一轮可以填入多个位置,但如果只按置信度排序,早期选中的内容未必能帮助解决剩下的歧义。
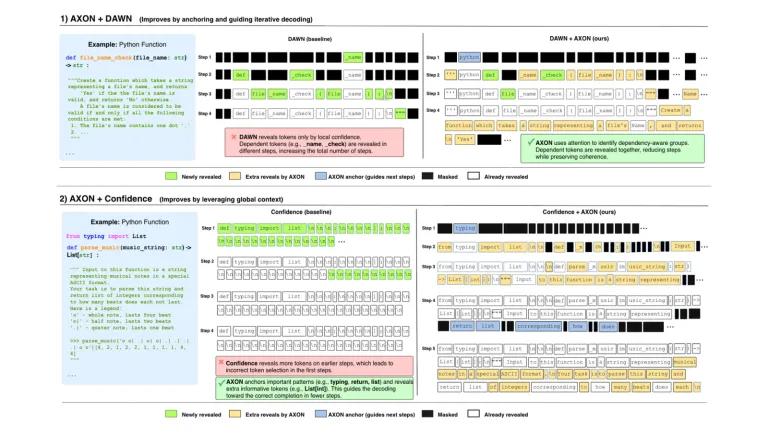
AXON 观察仍不确定的位置依赖哪些上下文,从高置信度候选中挑出能为后续步骤提供线索的词元。它可以附加到已有并行解码器,无需另行训练。作者分别报告不同模型和任务的结果。
修订版将测试扩展到 TruthfulQA 等任务,同时报告模型前向计算次数,便于判断速度提升的代价。
配图取自Ayoub, Giries Abu 等的论文图 4,按 CC BY 4.0 使用,等比缩放。