
 研究

连续强化学习中,一个模型按顺序学习不同任务,后面的训练可能冲淡此前的进步。11 月 19 日发布的 CoLiR 预印本研究了一个预算问题:只能留下少量旧题时,该把哪些题留给下一轮训练?
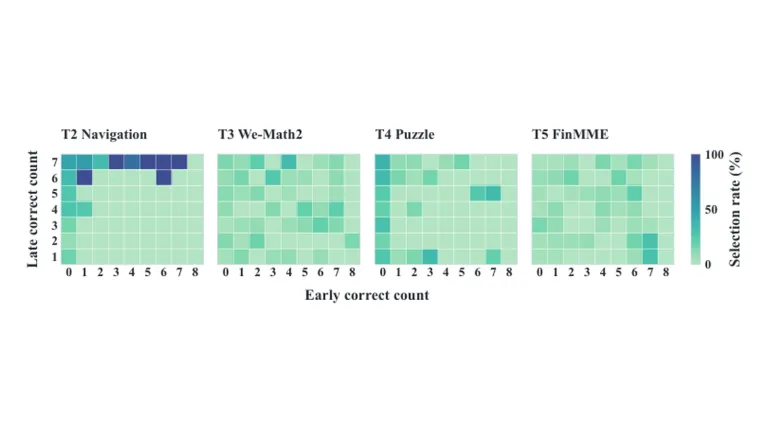
作者分别观察一项任务开始和结束时的模型,比较正确作答的概率提高了多少、错误作答的概率下降了多少,据此挑选值得回放的提示。后续训练从保留的提示中均匀抽样。筛选重用训练过程中已有的候选回答,仍需做额外评分,但无需为建立记忆库再生成一轮回答。
在 MRCL 的连续任务测试中,作者对三个规模的 Qwen3-VL 模型进行了比较。CoLiR 在所比较的方法中取得最高的平均最终准确率和平均任务准确率。其优势是否能延伸到架构不同的模型或更长的任务序列,还有待测试。
配图为 Qin-Wen Luo 等 的图 4。封面等比缩放并留白。CC BY 4.0 许可。