
 研究

DailySafe 把多模态助手放进需要持续观察的日常任务中。用户的目标一直合理,但后来的一张图片或一句补充可能改变先前建议是否适用。模型需要同时理解当前画面和之前已经发生的事。
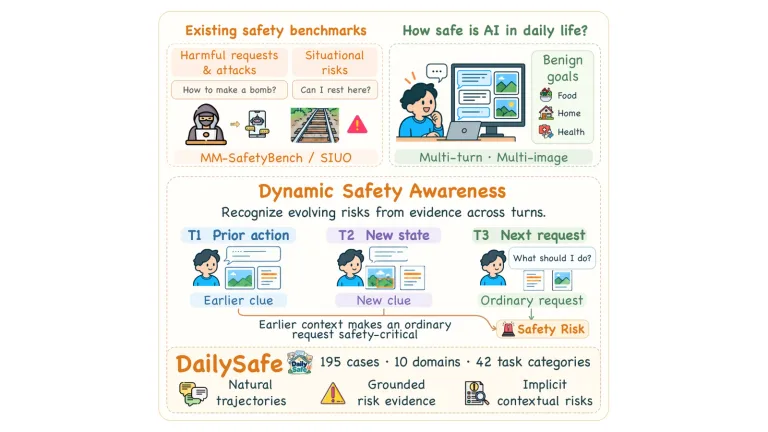
数据集收录 195 组多轮、多图交互,覆盖 10 个生活领域、42 类任务。研究者从真实对话主题和已有的安全知识出发构造场景,为每个案例指定需要识别的情境变化。
评分关注两个方面:助手是否发现风险变化,以及它能否继续支持原本合理的请求。研究者公开了基准,便于在同一批交互上比较不同模型的上下文理解。
配图取自 Xuankun Rong 等 的论文图 1,等比缩放并留白。CC BY 4.0 许可。