
 研究

使用远端语言模型时,服务端通常会看到用户提交的查询。直接对输入施加更强噪声有助于隐藏部分信息,也可能让回答偏题。11 月 19 日发布的 DP-SPD 预印本研究另一种思路:在客户端准备多个合理候选,把真实请求与候选请求一起扰动并随机排序,再提交给模型。
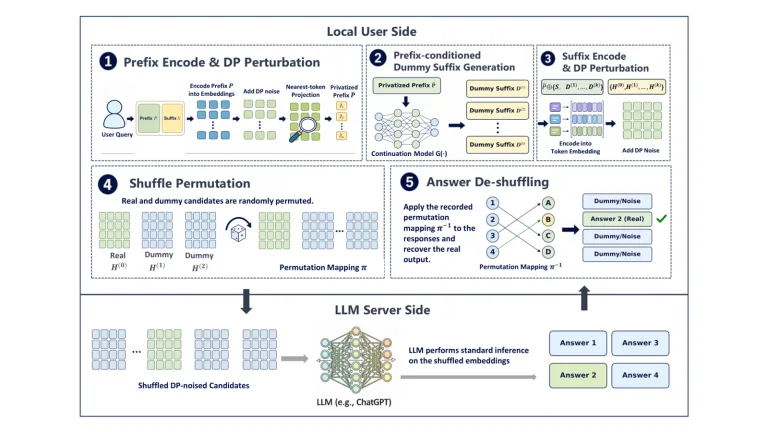
多发请求自然会增加计算开销。研究者利用同组查询之间共享的前缀,在生成阶段复用已经计算过的缓存,并比较分类、文本生成和隐私评估中的表现。论文区分了可以接触模型输入表示的情形,以及应用端只能调用远程 API 的情形。
在只能使用 API 的测试中,系统在 SST-2 情感分类上的准确率为 90.60%,在 QNLI 上为 91.31%。作者说明这组数字来自一个固定噪声种子,因此不宜把它与另一种设置的细小差距解读成稳定优势。实验所用隐私假设和额外请求成本,也需要随准确率一起考虑。
配图取自 Zhihao Liu 等 的论文图 1,按 CC BY 4.0 使用,等比缩放并加白边,配图沿用同一许可。