
 研究

11 月 19 日,Yutong Guan 等人公布长视频问答方法 EvoMem。面对“某个动作之前发生了什么”一类问题,按画面或字幕相似度检索容易反复找到相同片段,也可能错过连接两个事件的中间线索。团队把时间顺序纳入每一步检索。
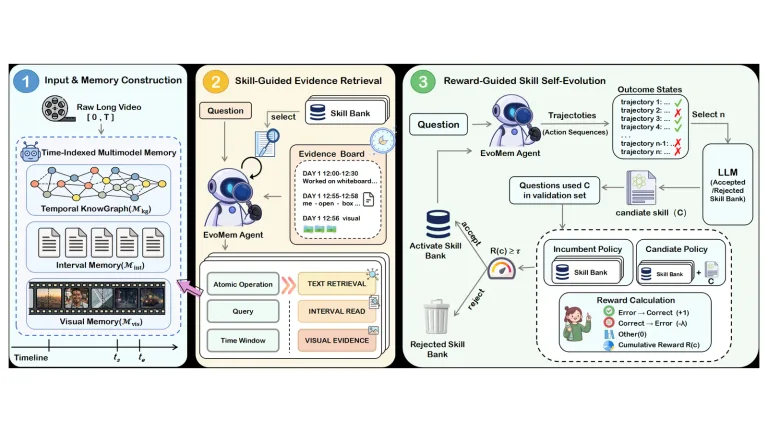
EvoMem 先构建分层的时间索引,把不同形式的证据对齐到同一条视频时间轴。一次检索取得线索后,系统用其中的时间信息限制下一次要查的位置,并决定该继续查找还是停止。团队在验证集上观察答案由错变对或由对变错的情况,用这些变化筛选检索策略,整个过程无需更新底层模型参数。
作者在四个长视频问答基准上报告平均准确率 60.1%,相对论文选取的先前最佳基线平均高 8.6 个百分点。这个结果比较的是特定模型、数据和检索配置,不能解读为任何视频加上时间索引就会获得相同幅度的提高。
配图为 Yutong Guan 等 的图 2。封面等比缩放并留白。CC BY 4.0 许可。