
 研究

11 月 19 日,Filippo Galgani 等人公布多词元预测方案 G-MTP,用一个轻量草稿模块为 Gemma 4 提议后续词元,再由主模型并行核验。推测解码的收益取决于两笔账:一次能让主模型接受多少候选,以及为了写出这些候选额外花了多少时间。
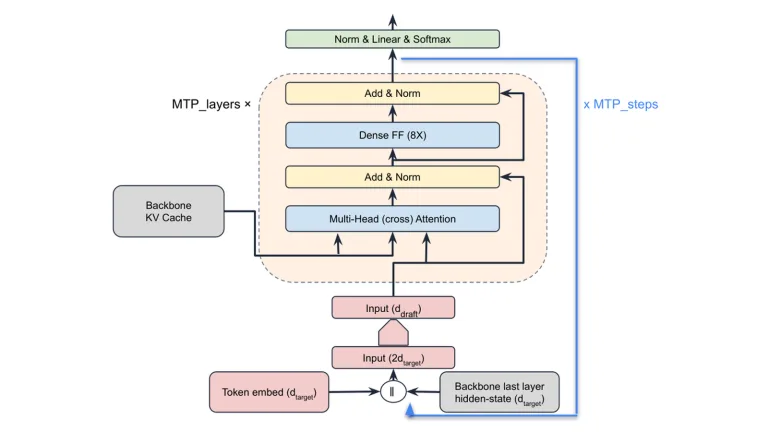
团队让多个预测位置共享一个草稿头,把主模型的隐藏状态提供给草稿模块,并通过交叉注意力复用已有的键值缓存,减少重复的预填充计算。另一个改动把词表投影分组处理,降低每一步都计算完整词表的代价。
论文报告,大型服务器配置的最高加速为 3.1 倍;面向端侧的小模型在 H100 测试中最高 2.3 倍,在手机 GPU 上最高 2.2 倍。作者还观察到,尝试起草更多词元有时反而会让吞吐下降,因为提议和核验本身也需要时间。具体设置应以整次生成实际花费的时间比较。
配图为 Filippo Galgani 等 的图 1。封面等比缩放并留白。CC BY 4.0 许可。