
 研究

常见的稀疏注意力方法会挑选一部分词元。HiSA 探索另一个方向:保留原来的查询与键投影,根据旋转位置编码的结构,只选取向量内部的一部分乘积来计算注意力分数。
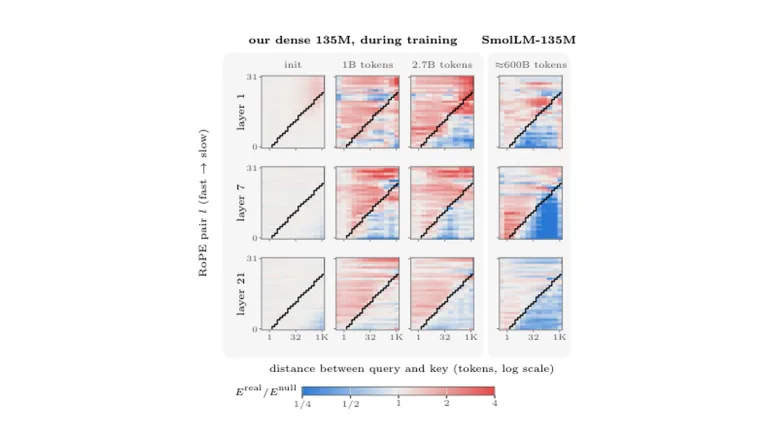
研究者从头训练测试模型。论文报告,在相应设置中,只计算约三分之一的查询与键乘积仍能保持或提高所测表现;团队还分析了普通稠密注意力如何逐渐压低部分分量的作用。
作者将这种计算方式扩展到 FlashAttention-3 内核,并报告解码提速及内存占用下降。节省的乘积比例指注意力内部运算,不能直接换算成整模型的加速倍数。
配图为 Ambroise Borbely 等 的论文图 4,封面等比缩放并留白。CC BY 4.0 许可。