
 研究

将同一份答案分别放在不同评分区间里,按理说换算后应当接近。Doyun Kim 等人 11 月 19 日发表的预印本测试了一个经常被忽略的细节:即使答案、提示词和裁判模型不变,量表本身也会改变评分。
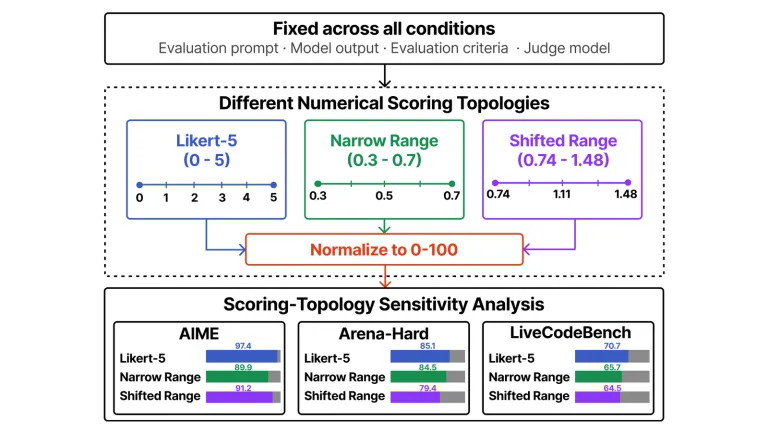
作者分别考察量表宽度、刻度间隔、起点偏移、对称性和边界位置。他们把分数换算到可比较的尺度,再检查区分答案质量、分数校准和跨量表稳定性。需要更多主观判断的任务对这些选择尤其敏感。
在多组测试中,整体平移或区间较窄的量表经常产生较大的偏差。较强的裁判模型总体上更稳定,但仍有差异。对需要横向比较模型的评测来说,原始评分范围和换算规则也应与最终分数一起报告。
配图为 Doyun Kim 等 的图 1。封面等比缩放并留白。CC BY 4.0 许可。