
 研究

11 月 19 日修订的 LongBEL 论文新增跨数据集测试。它处理的是文献标注问题:将一段文字里的术语对应到知识库概念。LongBEL 在判断当前术语时,可以读取整篇文档和已经作出的预测。
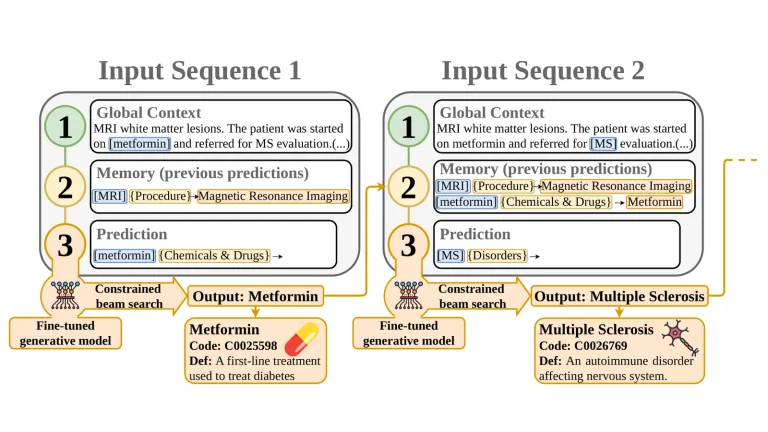
研究者在三个数据集之间进行两两迁移,形成六个方向。两个系统都使用 Llama-3-8B,在目标语料上都没有额外训练;预测时可以访问目标知识库,但看不到目标标注。作者报告,LongBEL 的首选答案命中率比句子级基线高 5.4 至 15.6 个百分点。
使用哪一个知识库会改变测试难度。作者在附录另列更严格的结果:把训练时的知识库也原样带到目标语料。两组结果分开报告,让读者能区分文档上下文的帮助与知识库覆盖范围的影响。
配图来自 Adam Remaki、Xavier Tannier、Christel Gérardin,图 2。封面等比缩放并加留白,沿用 CC BY-SA 4.0 许可。