
 研究

一次推理可能大多正确,却在中间某一步偏离指令。研究者先让模型生成回答,再由编辑器按给定标准找出第一次偏离的位置,提出一小段替换文本,训练时只监督经过修改的部分。
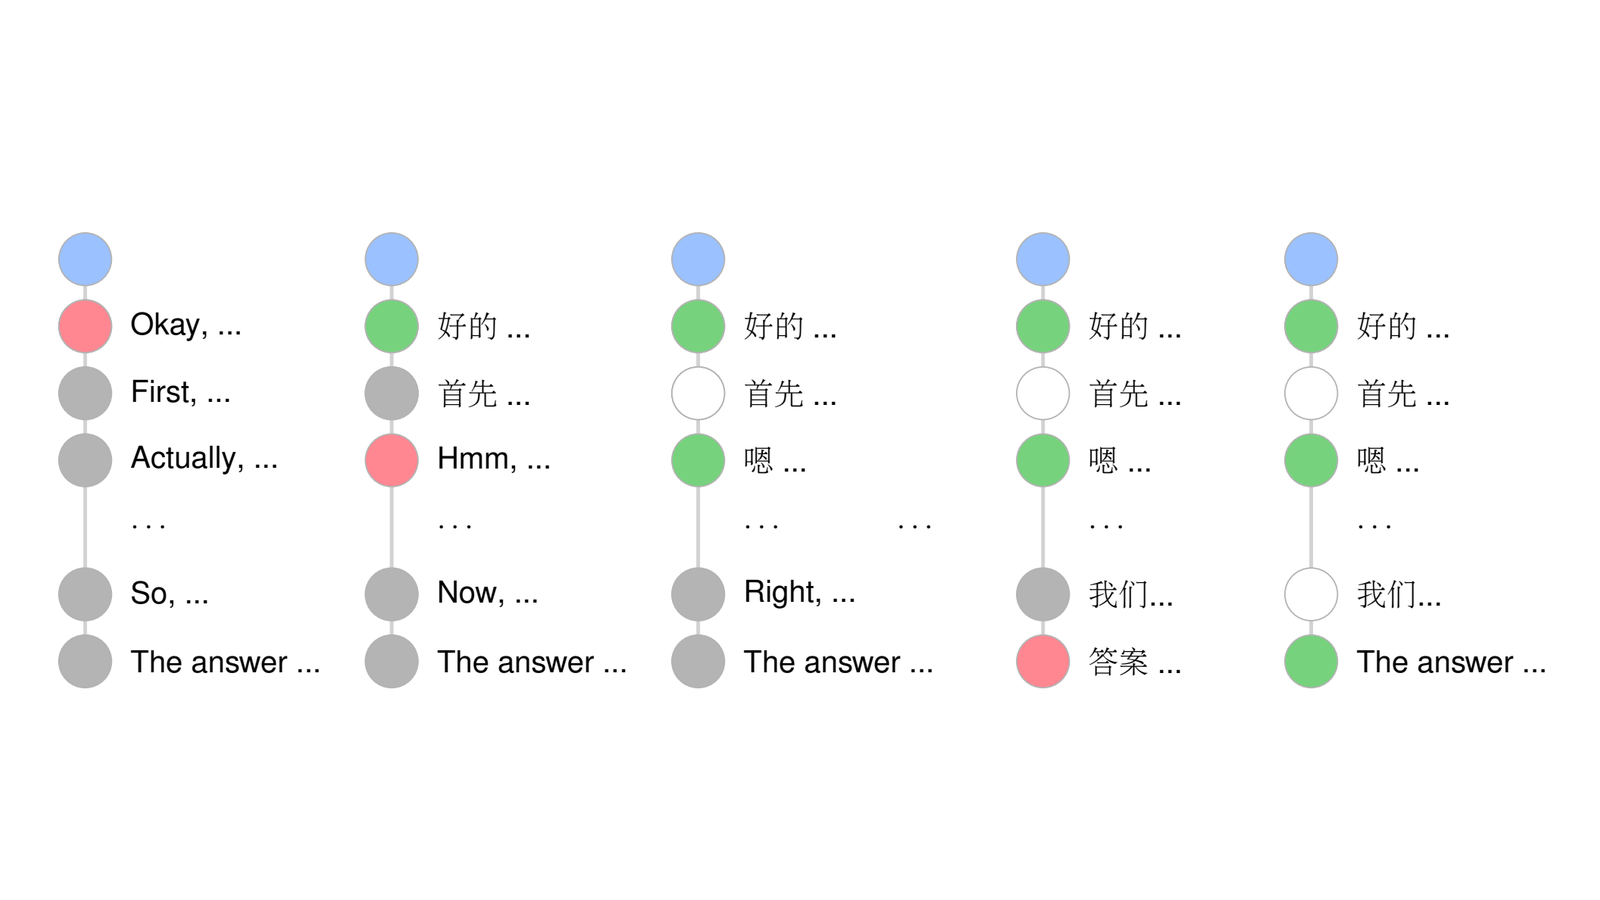
方法既能用于预先生成的样本,也能在线应用。在线版本随着待训练模型的变化重新观察其输出,让后续训练集中在它当前仍然容易犯错的位置。
论文在 Qwen3-32B 上采用 ReasonIF 做测试。作者报告,相较整段模仿与整段奖励基线,局部修改提高了遵守推理指令的表现,同时大体保留了若干非目标任务能力。
配图为 Alexandra Yakovleva 等 的论文图 1,封面等比缩放并留白。CC BY 4.0 许可。