
 研究

在论文指定的整数基准与 SkyWater 130 纳米流程上,作者报告新设计的运行时间加速比为 2.34。
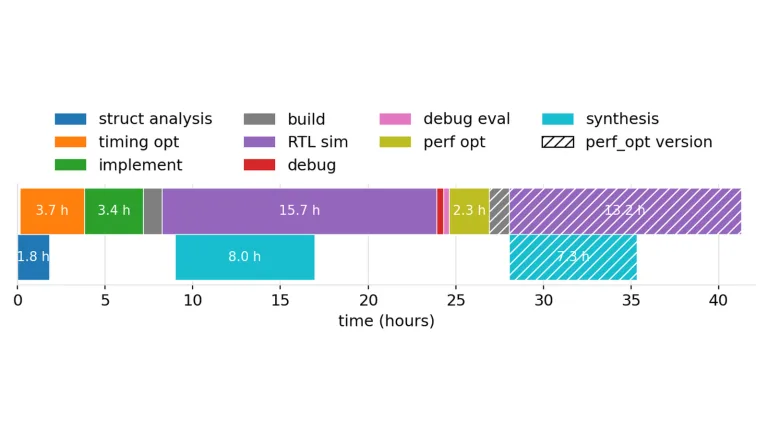
研究团队让智能体读取 RTL 运行和综合反馈,定位会拖慢处理器的环节,再在面积和关键路径约束下修改 Berkeley Out-of-Order Machine 的设计。
在完整参考输入的 SPEC CPU2017 intspeed 上,作者报告每周期指令数提升 85%,可达频率提升 27%。加速比来自该设计流程和基准,不能直接外推到其他制造节点或芯片。
配图出自 Cui, Angela 等 的图 5,等比缩放并留白。CC BY 4.0。