
 研究

在可分析的教师—学生模型中,团队把损失拆成与表示长度、方向对齐有关的两个部分。不同优化器可以让其中一部分下降得较快、另一部分较慢;同一次训练曲线的斜率因此不能直接替代数据规模律。
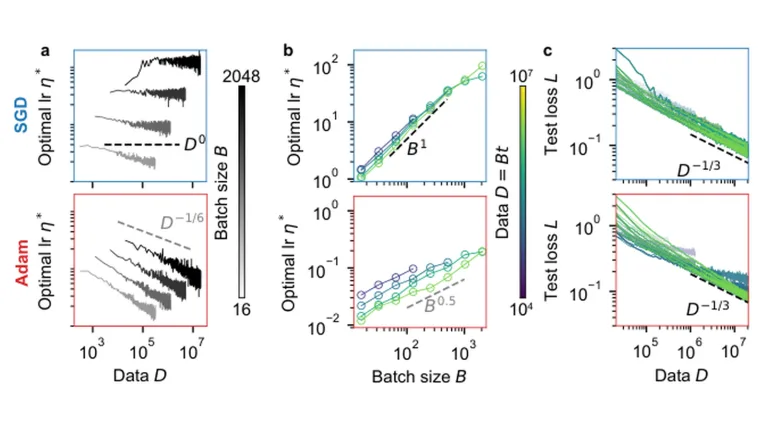
研究者在不同数据量下分别调整学习率,比较七种优化器能够达到的最优损失。包括 SGD、Adam 和 Muon 在内的结果与约为负三分之一次方的数据关系相符;适合各优化器的学习率却不相同。
修订分析讨论了偏离两部分完全独立这一近似后会怎样。结论依赖这里的模型、训练条件和调参过程,不能从中推出大型生产模型都具有同一指数。
配图取自Lee, Hyunseok 等的论文图 3,按 CC BY 4.0 使用,等比缩放。