
 研究

11 月 19 日,Zhiyang Xun 等人公开 PosteriorBench,专门比较语言模型罕见行为的采样方法。假设研究者关心一个万分之一才会出现的输出,只靠反复生成往往要等很久。改写提示词可以提高命中率,却也可能改变命中样本本身的特征。
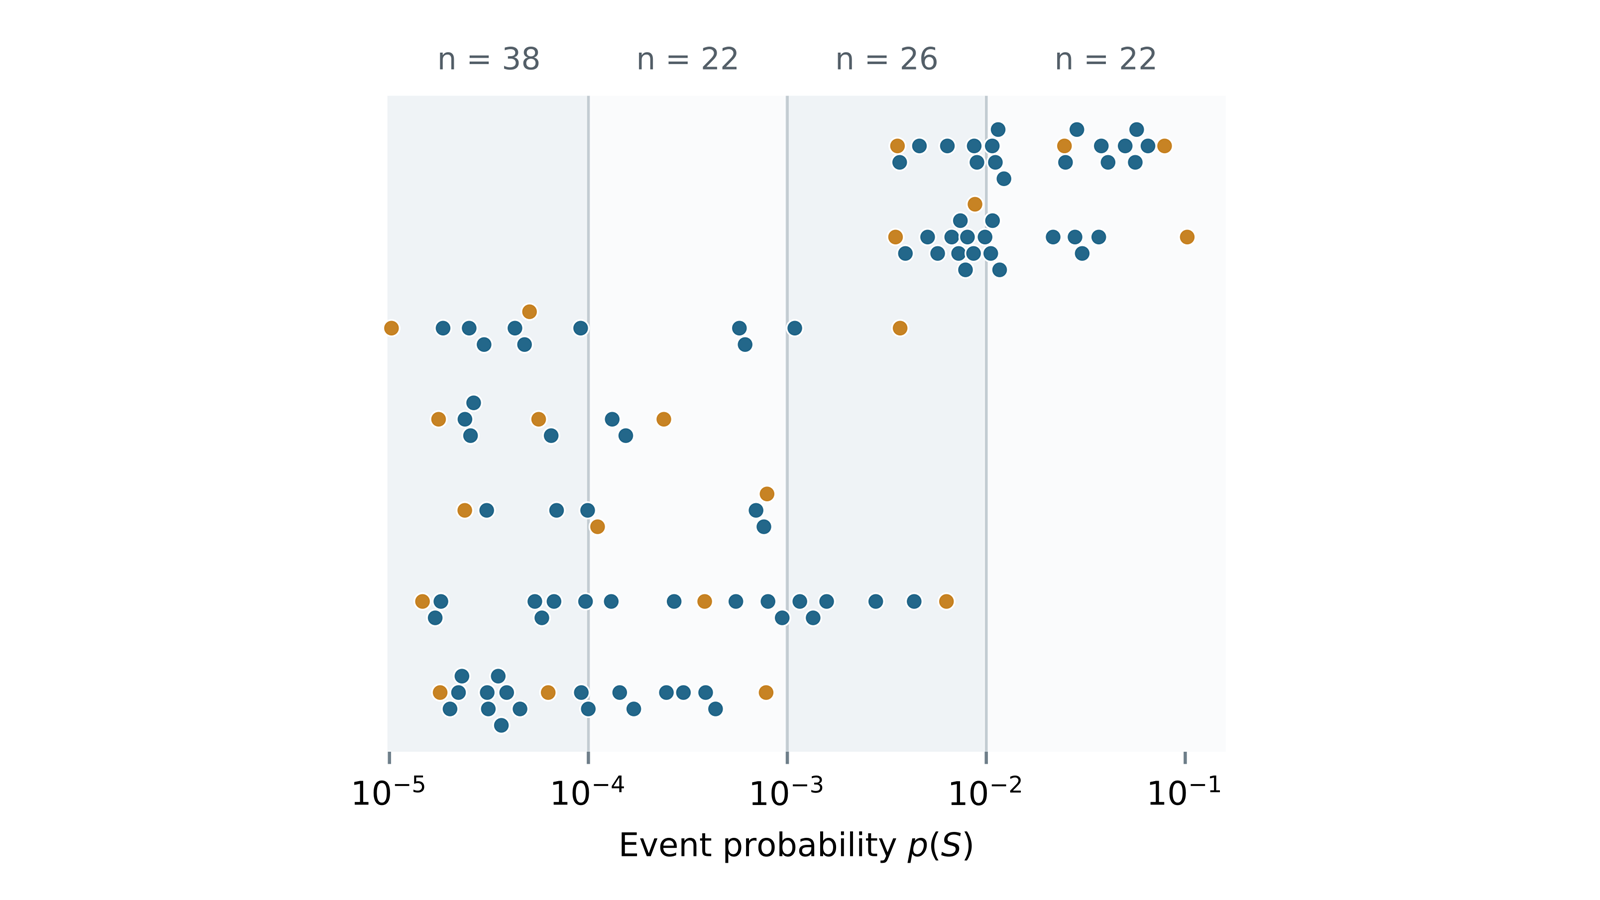
团队为 Qwen3.5-0.8B 的十亿条回复打上标签,从中构建 21 项任务。任务对应行为的自然出现概率从十万分之一到十分之一不等。研究者用计算成本衡量取得样本的代价,再以两个方向的 KL 散度比较样本分布和模型在原始条件下自然出现该行为时的分布。
在这些任务上,提示词引导的成本较低,但生成结果与自然条件分布有明显偏差。用真实条件样本微调可以改善部分结果,获取训练数据的成本又成为限制。所测方法尚未同时解决两方面的问题。实验依赖一个小模型和可以标注的行为,结论的适用范围也由此限定。
配图取自 Zhiyang Xun 等,图 3 的概率分布部分。封面等比缩放并留白。CC BY 4.0 授权。