
 研究

团队让 AI 改进一套机器学习方案时,经常能得到许多版本的代码,却很难看出每次改动究竟解决了什么。11 月 19 日公开的 Pro² Agent 预印本尝试改变实验记录的中心:除了保留代码,还持续维护一份问题清单,列出疑似瓶颈、候选方案和各自的依据。
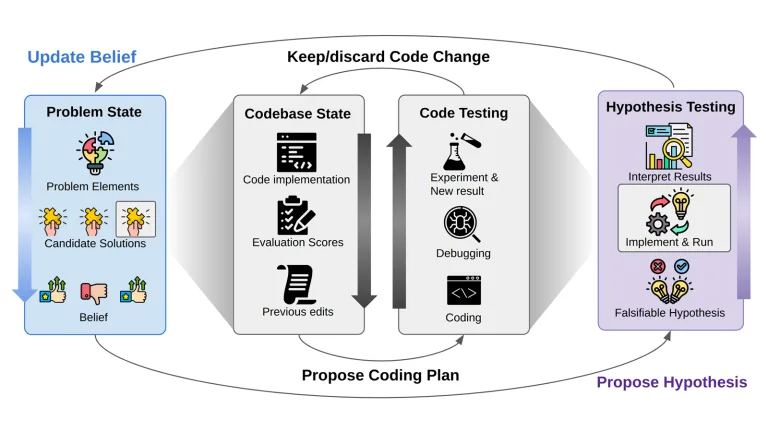
每次实验开始前,智能体先查看已有资源和约束,再选择一个有区分力的假设做对照。观察结果会改变它对瓶颈重要性和候选方案收益的判断。这样,即使一次尝试没有带来更高分,研究者仍能从记录里看出哪些解释得到了支持,哪些方向暂时不值得继续。
在完整 MLE-Bench 上,作者报告该系统在标准 24 小时预算内取得 70.7% 的奖牌率,与此前报告的最好结果持平。把每项任务的预算增加到 48 小时,奖牌率升至 76.0%。两项成绩对应不同的计算时间,比较系统效率时需要把预算一并看进去。
配图取自 Yixiong Chen 等 的论文图 1,按 CC BY 4.0 使用,缩放并加留白。