
 研究

11 月 19 日,Aarne Talman 等人公开一项关于英语朗读重音的研究。同一句话可以因说话者强调不同的词而有不同听感。研究者把相同一批词交给只读文本的模型和能够听到录音的模型,要求预测每个词在朗读中的三个重音等级。
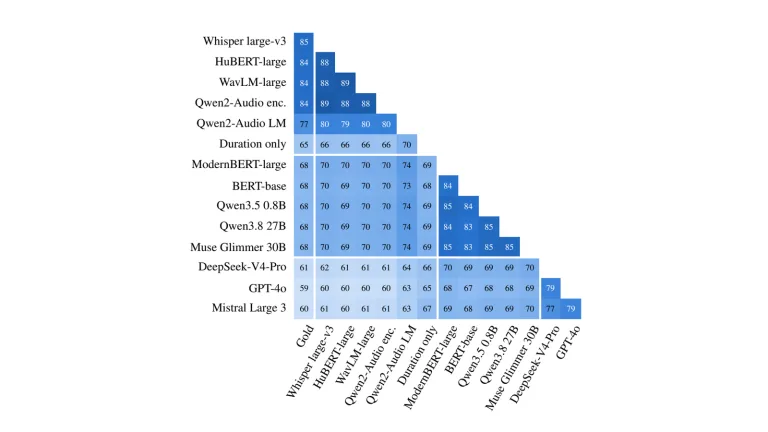
最好的文本模型三分类准确率为 68.8%,不同文本模型最后只相差约一个百分点,而且往往错在相同的词上。直接向大语言模型提问时,即使给出 500 个示例,所测提示也没能超过按每个词最常见标签猜测的基线。换一种读法,从模型内部表示训练简单分类器,却能取出更多与重音有关的信息。
语音模型在同一任务上达到 84.7%。这个差距对语音合成很重要:文字能缩小强调位置的选择范围,而实际读者的语气还要从声音里判断。论文使用带逐词标注的英语朗读数据,数字不能直接推广成所有语言或自然对话的表现。
配图为 Aarne Talman 等 的图 2。封面等比缩放并留白。CC BY 4.0 许可。