
 研究

11 月 19 日,YaJie Yin 发布一项对 Qwen2.5-Instruct 的行为测试。作者选择五个从 0.5B 到 32B 的模型,在四种提示条件下对固定任务反复采样,两名 AI 评分器共评定 600 条交互轨迹。研究分别观察模型会不会写出指定的检查格式、会不会承认现有信息不足,以及是否真正完成诊断。
在信息充足的那组任务中,从 3B 到 32B 的几个模型采用核查提示后,60 条记录全部出现可评分的格式标志,常规提示下的 60 条则一次也没有。可是经过复核,两组中达到“实际执行诊断”标准的都只有 1 条。进一步看所有规模和提示下的 300 条信息充足记录,过线的 7 条全部出现在同一道题上。
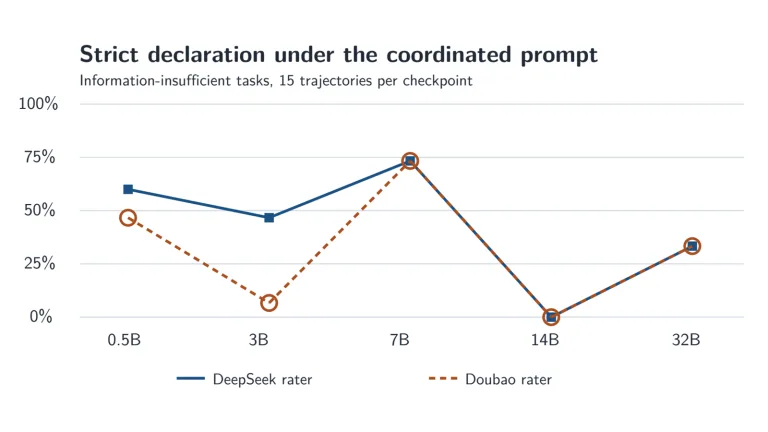
信息不足时,模型规模与行为也没有简单的递增关系。在同一种组合提示下,两名评分器都记录到,7B 在 15 次中有 11 次明确声明信息不足,14B 为 0 次,32B 为 5 次。每种信息条件只有三道固定任务,每题生成五次,而且自动检测到追问后才由程序补充消息。这些计数描述的是这套具体交互。
配图取自 YaJie Yin,论文图 1,等比缩放并留白。CC BY 4.0 授权。