
 研究

如果一份量表原来规定 5 分代表优秀,新版本改成 1 分代表优秀,评价标准本身并没有变。11 月 19 日发布的预印本借此检验 AI 评审:给它同一份待评答案,只把评分说明里数字与等级的对应关系反过来,再将结果换回统一方向比较。
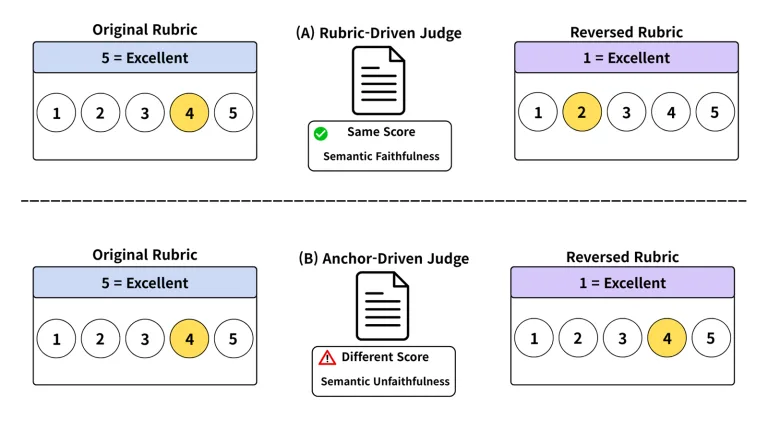
团队在五组元评测基准上测试了七种模型,覆盖开放权重与专有模型。结果显示,模型不总会按照文字说明切换分数。作者还测量了模型在量表不变时重复评分的波动,以此判断观察到的差异有多少超出了正常浮动。只看正反两次是否一致,容易混淆这两种情况。
在这组实验里,让模型按两种方向分别打分,再换算并取平均,可以降低结果对单一刻度方向的依赖,同时保留与人工评价的对齐程度。对需要用模型给回答排序的团队,这提供了一个容易复查的对照:保留答案和标准,单独改变数字含义,看看排名是否也被带着走。
配图取自 Chanwoo Kim 等 的论文图 1,按 CC BY 4.0 使用,等比缩放并加白边,配图沿用同一许可。