
 研究

检索增强生成系统把检索到的材料放进上下文,但模型已有的知识可能与材料不一致。SPARK 团队研究了一种可学习的调节方式,在生成回答时改变内部知识参与的程度。
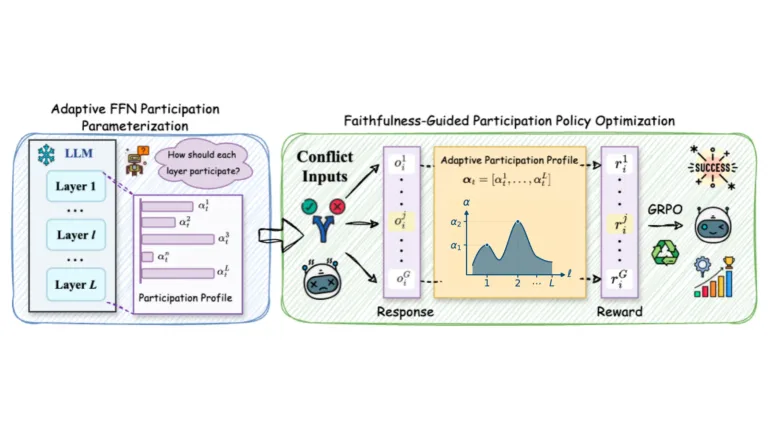
作者在模型各层引入轻量策略,按当前任务调节前馈网络的信息贡献。修订版补充了多个问答数据集的并列结果,并报告 ConFiQA 在开放问答与选择题两种形式下的比较,便于读者判断题型对表现的影响。
研究区分了遵循给定证据与独立判断证据真伪。即便模型能更稳定地依照上下文作答,检索材料的可靠性仍需另行检查。
配图取自Li, Ruochang 等的论文图 2,按 CC BY 4.0 使用,等比缩放。