 音频

在多人用不同语言同时说话的录音中,告诉系统“提取哪一种语言”只能提供一个类别。研究者让预训练语音模型从混合声音中生成更偏向目标语言的语义表示,用于指导分离。
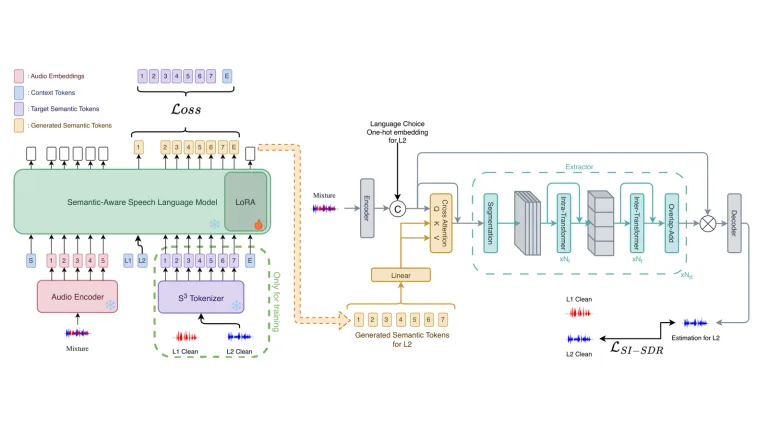
团队用与语言有关的提示和参数高效微调改造语音模型,再把提取到的表示送入原有分离模型。这样,分离步骤可以同时参考声音特征与语言内容线索。
论文报告,在 CommonVoiceMix 实验中,相较仅做声学建模的基线,尺度不变信号失真比(SI-SDR)最高提高 1.16 分贝。这个指标描述分离后的信号质量,不能直接换算成听众理解率。
配图取自 Mehmet Sinan Yıldırım 等 的论文图 1,等比缩放并留白。CC BY 4.0 许可。