
 研究

一项研究模型如何从上下文示例中提取任务规律的预印本于 11 月 19 日更新。作者把从示例中提取的干预方式称为「任务算子」,并增加了改变示例抽样后结果是否稳定的报告。
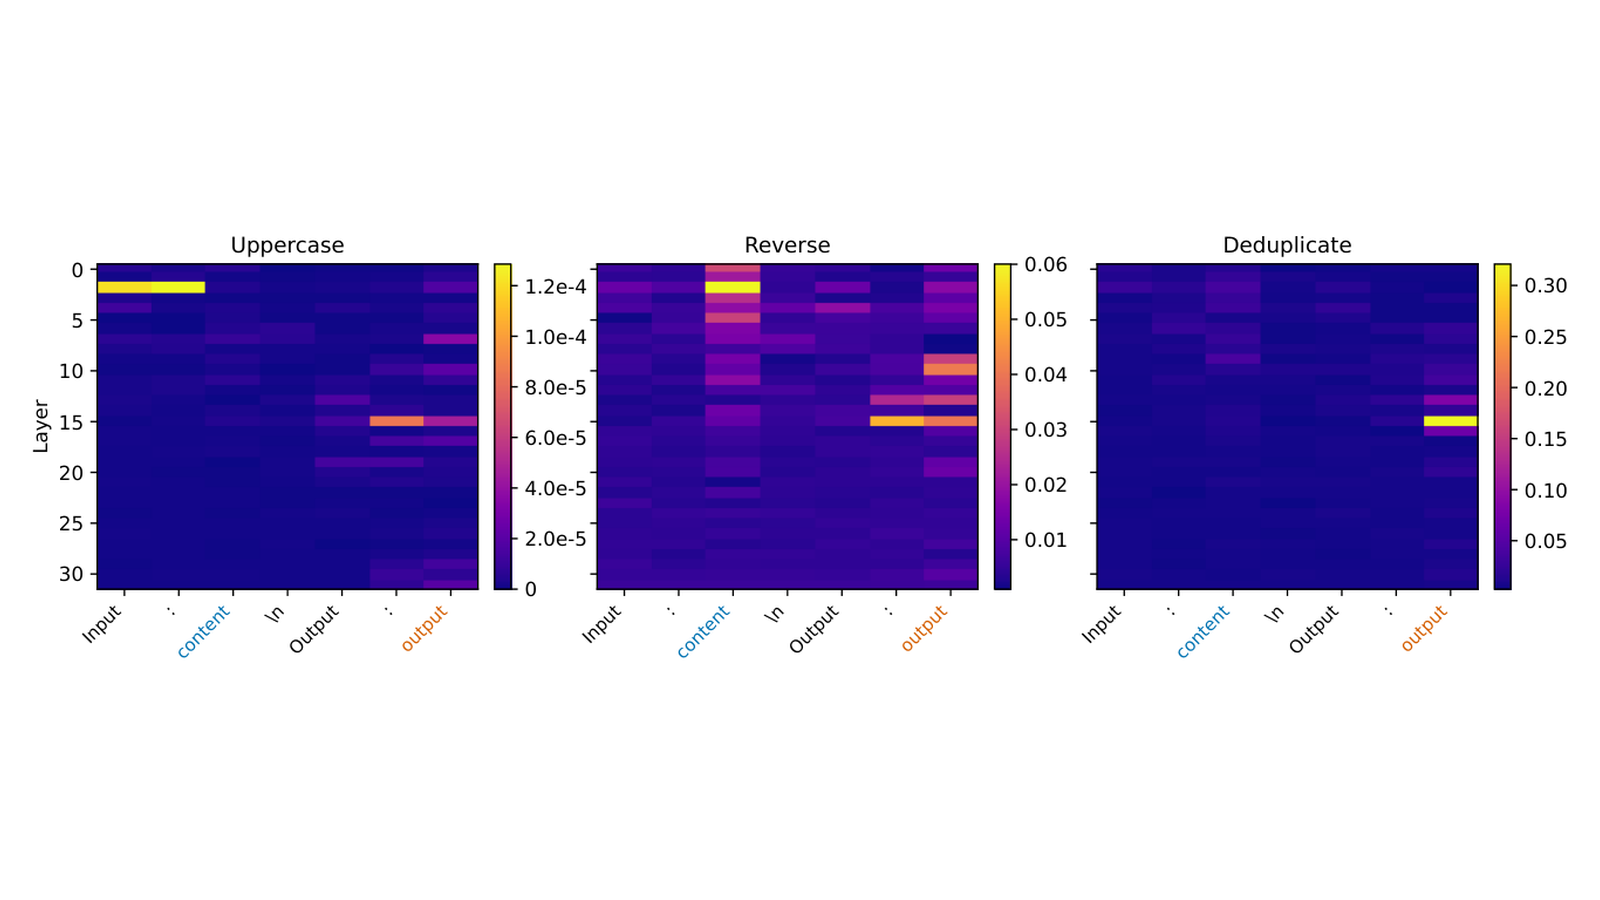
新版本表 2 用 10 个随机种子选择去重任务示例,用 5 个随机种子选择 GPQA 示例。在 Qwen3-8B 上,作者报告任务算子的去重准确率为 63.9%,标准差为 8.7 个百分点;GPQA 则为 29.5%,标准差为 2.7 个百分点。
这两组数说明,示例抽样给两项任务带来的波动不同。论文同时给出其他方法在相同抽样方式下的结果,便于读者检查一次运行是否具有代表性。
配图来自 Xiong, Guangzhi 等,图 2,按 CC BY 4.0 使用。