
 研究

判断口语模型有没有听懂用户,不能只看它能否复述听到的声音。TELEVAL 团队记录了一类反复出现的失误:模型能够识别语气或背景声,却只描述这个线索,没有回应说话人真正需要的帮助。
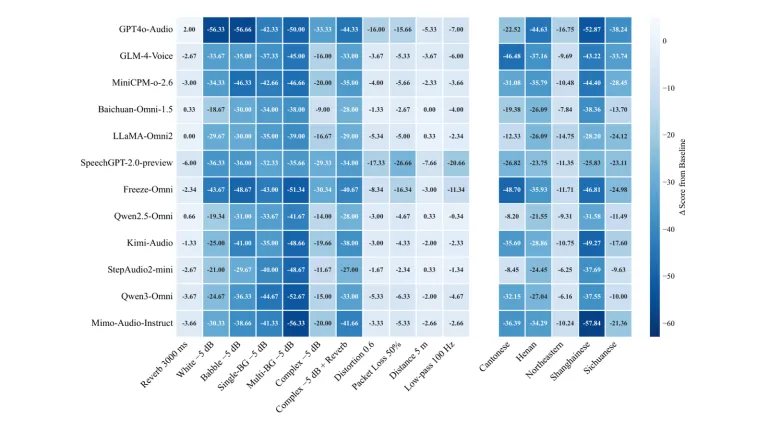
修订版把 GPT-4o、Qwen3-30B-Instruct 与独立人工评价放在一起,检查更换评分者后,不同模型的得分和排序如何变化。论文也标明哪些测试材料沿用旧数据、哪些经过转换,并讨论选择题与自然询问的差别。
作者发现,事实问答上较强的模型未必能同样处理方言、噪声和本地文化知识。按任务及评分者分别查看结果,更容易看出识别声音和组织恰当回答之间的差距。
配图取自Li, Zehan 等的论文图 5,按 CC BY 4.0 使用,等比缩放。