
 研究

扩散语言模型翻译一句话时,可以同时修改多个位置,但预留的译文太长,就会把计算浪费在空位置上。11 月 19 日公开的 TRAC 预印本提出一种无需重新训练的解码方法:先根据原句长度和翻译方向估算目标长度,遇到空结果或异常短的结果,再退回较宽松的长度设置。
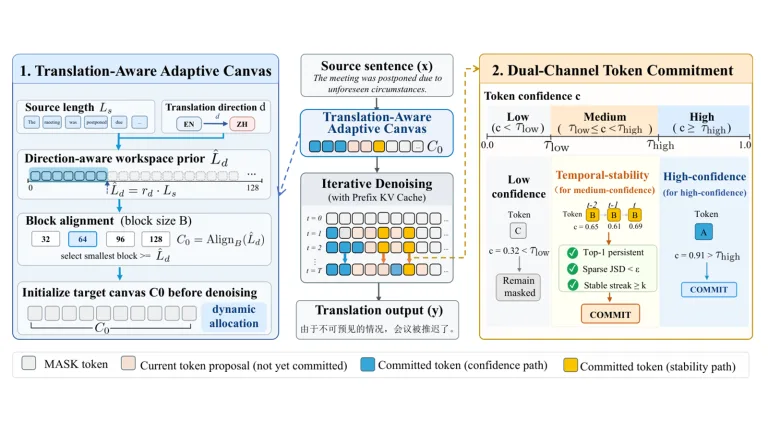
另一个浪费来自反复计算已经相当稳定的词元。TRAC 除了接受置信度高的预测,还会比较连续步骤中首选词元是否保持一致、候选概率是否发生明显变化。对于置信度中等、但多轮预测已趋于稳定的位置,系统可以提前确定,把后续计算留给仍有分歧的部分。
在 FLORES-200、WMT23 和 NTREX-128 的中英双向测试上,相比 Fast-dLLM,作者报告前向调用减少 24.9% 至 36.8%,单句生成速度为原来的 1.91 至 2.19 倍,宏平均 COMET 下降 0.02 点。这里测量的是指定模型的单句生成速度,未包含在线服务的排队和网络等待。
配图取自 Tianyuan Li 等 的论文图 3,按 CC BY-SA 4.0 使用,等比缩放并加白边,配图沿用同一许可。