
 研究

11 月 19 日,Samir Khaki 等人公布 VR-SparseQuant,研究如何让低精度模型在 NVIDIA Rubin 架构上兼顾数值精度和计算速度。方案利用硬件支持的 2:4 稀疏格式,每组四个位置保留两个数值,并允许不同数据流在同一位置叠加。
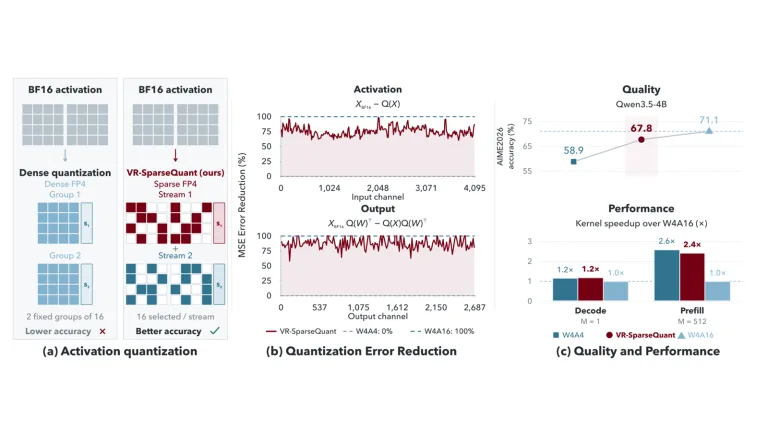
叠加给了量化器另一种分配表示能力的方法。在总数值预算受限时,难以用单个 FP4 数表示的位置可以得到额外补偿,缩放因子则在运行前校准。在 WikiText-2 上,Nemotron-3-Nano-30B-A3B 的困惑度从稠密 W4A4 舍入基线的 6.85 降至 5.57。这项指标越低,代表模型对该测试文本的预测越好。
速度实验使用另一组对照。计入激活值准备开销后,作者在 Rubin 上测得矩阵乘法内核最高达到 BF16 基线的 3.1 倍,混合专家内核最高为 2.7 倍。完整应用还涉及内存、调度和解码等环节,这些数字所覆盖的是论文实际测量的算子。
配图取自 Samir Khaki 等,图 1。封面等比缩放并留白。CC BY 4.0 授权。