
 研究

11 月 19 日,Donato Riccio 和 Fabrizio Maturo 公布一项语言模型与阅读行为的对照研究。已有工作常用模型最后一层觉得某个词“有多意外”预测人的阅读时长。两位作者把问题往前推了一步:即使两个词在最后一层同样意外,模型需要经过多少层才形成这个判断,能否提供额外信息?
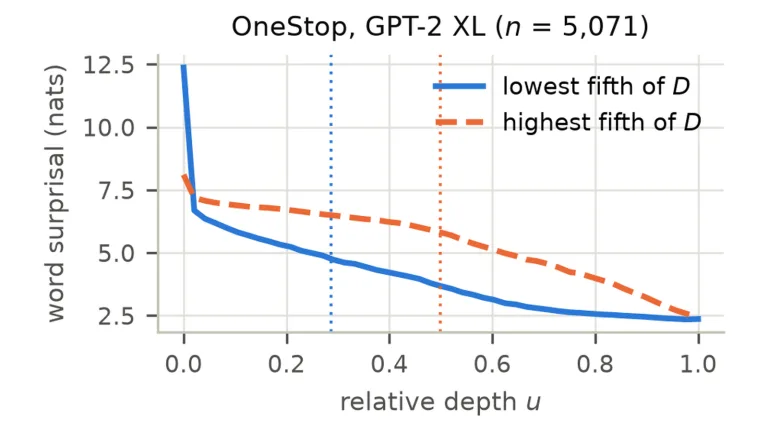
团队采用八套英语眼动或自定步速阅读语料,共 81,957 个词,与 GPT-2、OPT 和 Pythia 家族的十个模型比对。研究用探针逐层读取词预测,再计算预测变化主要集中在哪一深度。控制最后一层给出的意外程度之后,模型较晚才确定的词及其后续词,在实验记录中往往也读得更慢。
合并所有语料时,增加深度指标带来的留出集预测收益是每词 0.26 毫奈特,量级约为加入熵指标收益的三分之一。不过,各语料之间差异较大,一种随机效应汇总并未显示显著净收益。研究发现的是统计关联,不能据此把模型层数当成人脑阅读步骤的直接对应。
配图为 Donato Riccio、Fabrizio Maturo 的图 1。封面等比缩放并留白。CC BY 4.0 许可。