
UniPat AI 等研究者提出 Science Prediction Universe(SPU),用真实湿实验的测量结果评估 AI 智能体的预测。论文于 2026 年 11 月 11 日提交 arXiv;本篇为近期研究补录。
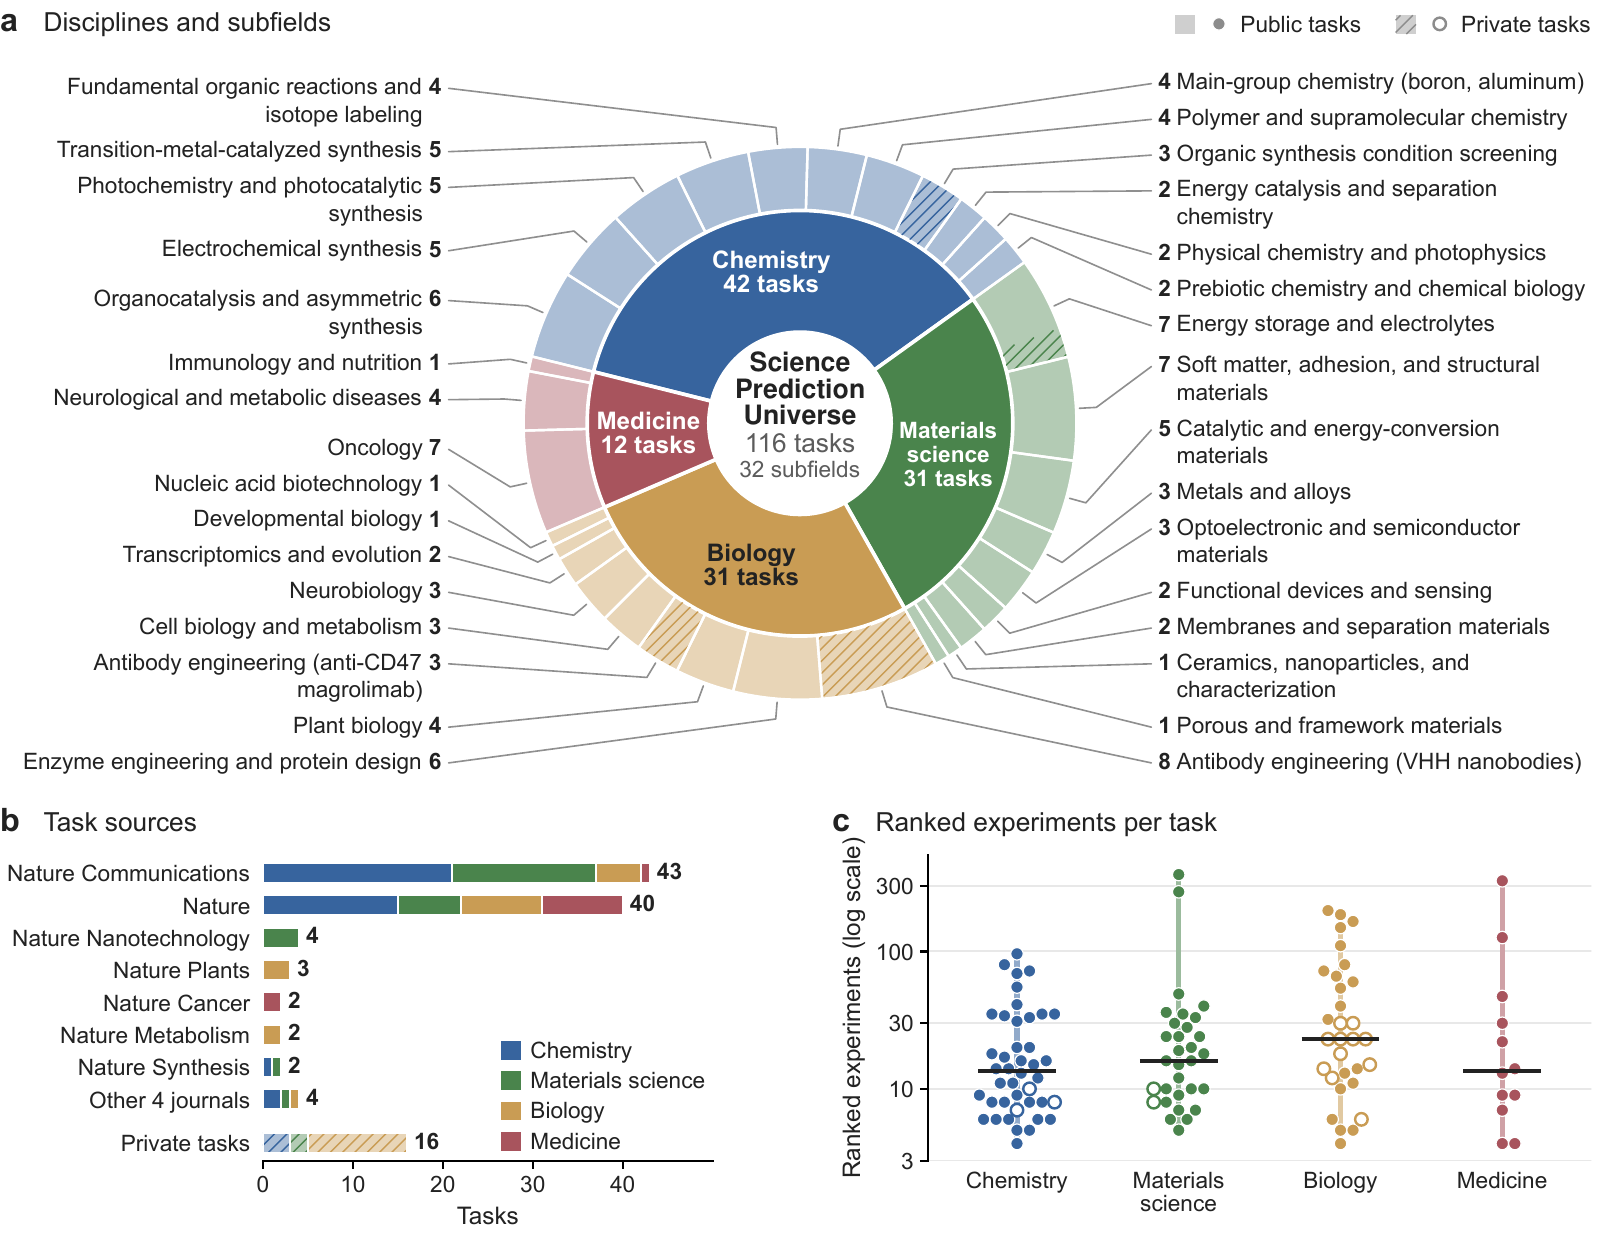
SPU 包含 100 项公开任务和 16 项来自未发表实验的私有任务,覆盖化学、材料、生物与医学。智能体根据实验条件给候选项排序,评分程序将排序与隐藏的真实测量结果比较。论文规定每次运行最多八小时,并可使用联网检索与计算资源。
作者在十二种模型、十三种配置上的实验显示,公开任务的任务难度调整后平均 Spearman 相关系数介于 0.227 至 0.478。该指标衡量排序与实测结果的相关性,不能当作答题正确率;这些仍是预印本作者报告的结果。
来源:arXiv · Science Prediction Universe、论文全文、UniPat AI · 项目说明。
配图:Zengji Tu 等,Science Prediction Universe 图 3,CC BY 4.0,作者仓库原图,未修改。
