NEWS DESK新闻资讯
人工智能日刊 · 第 13 页
最近发布的产品动态、研究进展与行业消息。
订阅
切换主题
- 安全arXiv
研究发现代码告警消失,不一定代表漏洞修复
对真实漏洞路径做保留缺陷的自然改写,检查静态分析告警是否仍然出现。 研究团队测试 CodeQL 的 JavaScript 污点跟踪,对 172 条真实 npm 漏洞路径做保留漏洞的自然代码改写,再以人工审计和受控实验确认漏洞是否仍在。 作者报告,定向改写可让其中 26.2% 的原告警消失;仅要求一般重构、不给告警信息时未观察到同样结果。论文把问题归结为若干库建模边界,强调告警变化与漏洞状态应分开验证,结果不代表 CodeQL 对所有代码都失去检测能力。
- 商业The Verge
研究发现 AI 购物回答会推荐冒牌与失效网站
研究覆盖 151 个品牌与 6795 条自拟问答,风险网址也包含无法购买的失效页面。 品牌保护公司 Podqi 与 AI 搜索数据公司 Gauge 对 ChatGPT、Gemini 和 Perplexity 进行购物问答测试,在涉及 151 个品牌的 6795 条回答中,约 9% 出现研究定义的风险网站。 其中既包括疑似品牌冒充与假货站点,也包括无法购买的失效页面,不能把全部风险网址都等同于诈骗。研究使用自拟问题,在 9 月两轮测试中采样,不代表所有真实购物对话的总体发生率。
- 应用微信群
Phota Labs 推出 AI 照片助手,调整构图与拍摄风格
从轻度构图修正到新视角变换,生成式处理后的照片须与原始纪实图像区分。 Phota Labs 推出 iOS 照片助手,用生成式 AI 调整日常照片的取景、构图和摄影风格。公司由曾参与 Adobe 计算摄影产品的 Cecilia Zhang 与 Zach Xia 创立。 据 TechCrunch 对创始人的采访,产品提供从保留原有镜头与构图的轻度调整,到改变视角、镜头效果等更明显的变换。公司强调维持人物外貌的一致性,官网提供应用入口。
- 前沿arXiv
OBM 提出用光广播共享推理权重的架构方案
分层光纤架构研究减少跨节点权重复制,尚非商用机房部署公告。 研究团队提出 Optical Broadcast Memory,通过分层光纤广播让多个推理节点读取同一份模型权重,减少在大量加速器本地重复存放只读参数。 方案用可调整的缓冲时间适配不同上下文与混合专家模型。论文给出数据中心规模的架构评估,比较吞吐和每 Token 能耗;这属于研究方案与建模结果,并非已有商用数据中心全面移除 HBM。
- 安全arXiv
研究改进语言隐写中的 Token 歧义处理
针对文本的多种 Token 切分,给出带条件的消息恢复容量边界。 一项预印本研究文本经过传输后出现多种 Token 切分方式的问题,并提出 coin projection,在单一历史记录约束下减少隐写消息提取损失。 作者给出带条件的容量边界,在英语、中文和日语实验中比较编码效率与完整消息恢复情况。结论针对论文设定的分布和提取要求,不意味着任意文本都能隐藏信息,或生成内容可以绕过所有检测。
- 研究Ai2
XYBench 测试 AI 能否识别提问背后的真实需求
8115 个问题区分字面请求与实际目标,相关论文此前于 9 月提交。 Ai2 介绍 XYBench,一套包含 8115 个问题的评测,用来检查 AI 助手是否只回答用户提出的做法,还是能发现错误前提并回应真正目标。问题覆盖编程、烹饪和家居维修等场景。 测试区分“给出解决方案”“识别误解”与“把正确目标作为回答重点”。团队发现,被测模型即使提到了更合适的解决办法,也常把主要篇幅留给用户原先选择的错误方向。
- 机器人arXiv
Ropedia Xperience 2 发布三维场景与人类操作数据
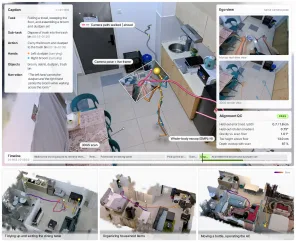
三维扫描与 131 小时第一视角行为记录相结合,探索可复用的机器人学习数据。 Ropedia Xperience 2 介绍面向物理 AI 的环境与行为数据:1589 个公开米制三维扫描,以及覆盖 74 类任务、共 131 小时的 4230 段第一视角记录。 团队展示如何把扫描场景转换为可交互仿真环境,将人类动作映射为机器人轨迹,并补充虚拟遥操作或自动生成的行为。论文目标是研究环境与行为数据如何共同扩展机器人学习,演示不等于机器人已能可靠执行全部真实长任务。
- 研究arXiv
tEHR 研究利用临床概念描述改进病历预测
以自然语言描述保留病历概念含义,在回顾性数据上检验多项预测任务。 tEHR 把结构化病历事件转成自然语言描述,先进行病历适应性继续预训练,再用 LoRA 完成具体预测任务,保留临床概念之间的语言语义。 团队在 MIMIC-IV 的四项任务及 CPRD 的胰腺癌预测设置中评估。删除或打乱临床描述、去掉数值都会降低表现。研究属于回顾性数据上的模型评估,未证明能够直接用于临床筛查或替代医生。
- 研究arXiv
新基准在真实论文中植入错误,测试 AI 审稿能力
比较十二种审稿系统的错误发现率与误报,工具收益随学科和任务变化。 研究团队在两组共 30 篇天体物理与机器学习论文中植入 357 处可定位错误,比较十二种 AI 审稿系统的发现率和误报率。 论文同时提出 Skepthical,用检索核对引用、计算机代数检查数学、运行代码检查数值。结果显示,模型选择影响很大,工具在补足模型缺少的信息时更有帮助;引用检索在两个学科中的收益并不相同。团队公开评测流程和裁决记录,结果不能外推为 AI 已具备完整同行评审资格。
- 视频arXiv
AURA 2.0 让视频模型主动发起对话并调用工具
加入主动对话、实时工具调用与视觉定位,开放权重和推理代码。 AURA 2.0 在流式视频交互中加入模型主动发起对话:模型根据正在发生的画面判断何时值得开口,不必始终等待用户提问。 另外两项更新是结合实时上下文的工具调用,以及把输入标记、输出边界框与对应视频帧关联的视觉定位。团队还加入长时交互记忆,宣布开放权重和推理代码。当前效果来自研究团队的公开基准与定向评测,不代表模型能在所有实时场景中准确判断插话时机。
- 研究arXiv
SchemaBridge 评估 AI 能否理解并重建数据库结构
把表、字段、类型及外键关系分开评分,避免只看文本相似度。 SchemaBridge 收集 902 套关系数据库结构,测试语言模型从需求设计表结构、把结构转成描述,再从描述还原结构的能力。 评测把表、字段、类型、非空约束、实体及外键完整性分开计分。研究发现,人写需求常缺少结构信息,明确要求模型完整描述能改善部分关系保留,但传统文本相似度分数未必随之提高。论文同时公开代码与数据,强调“说明写得像”与“数据库结构还原正确”并不等价。
- 研究arXiv
研究拆解可验证 AI 的证明成本与显存瓶颈
连接证明系统、密码学内核与硬件测量,发现容量和同步同样重要。 一项预印本把可验证 AI 的开销拆为工作负载、证明系统、密码学内核与硬件四层,并对六种证明器、七种内核进行测量。 结果显示,主导成本会随证明系统和输入长度变化;在文中特定的 130 亿参数微调证明配置中,40GB 显存无法容纳任务,80GB 设备可以完成。作者还发现指令发射和同步开销,不能只用带宽解释性能。这不是普通 130 亿参数模型推理的统一硬件要求。
- 安全arXiv
研究估计经过编辑的水印 AI 文本在语料中的占比
对经过未知程度编辑的水印文本估计整体占比,校准条件会影响统计界限。 研究者提出带编辑预算的统计方法,估计一批文本中来自水印语言模型的比例,而不只判断单篇文章是否带水印。 工作讨论 Gumbel-max 与 KGW 水印,考虑保留程度、替换和校准误差。作者发现,当样本扩大时,即使很小的零假设校准误差也可能破坏覆盖率;独立人工样本校准能改善这一问题。相关界限依赖编辑和统计条件,不能当成任意改写文本的可靠溯源工具。
- 研究arXiv
研究综述梳理如何调整系统对语言模型的依赖
依据证据动态调整依赖程度,同时区分一般错误控制与关键动作防护。 一篇新综述讨论,在规划、预测与判断等任务中,如何根据不断积累的可靠性证据调整系统对语言模型的依赖程度。 作者把决策理论、估计和在线学习方法与 LLM 系统相联系,并区分性能提升与关键错误防护:降低错误影响的频率,并不等于高风险错误绝不会执行。文中强调独立验证机制的作用,当前比较研究仍有限,未给出一个适用于所有智能体的统一可靠性保证。
- 研究arXiv
生物学 AI 综述提出明确记录模型知识边界
从数据到评估整理模型适用范围,帮助研究者记录输出的可靠条件。 研究综述讨论生物基础模型与智能体在蛋白质、基因组和单细胞分析中的使用范围,提出用“知识边界”描述输出在哪些输入和条件下可靠。 作者从数据、架构、训练、评估和后分析五方面整理边界来源,并提出对模型局限进行标准化描述,供研究人员及调用这些模型的智能体参考。文章是方法与证据综述,不是宣布新的药物、治疗结果或生物实验突破。
- 研究arXiv
Skill Adapter 为通用技能增加个性化适配层
把个人要求做成可组合适配层,在三项基准上比较技能选择与任务成功率。 Skill Adapter 把用户偏好、工具选择和执行反馈提炼成适配层,并与通用技能关联。路由智能体根据当前子任务和环境状态选择适用技能,再随执行进度更新候选。 作者在 ALFWorld、WebShop 与 SkillsBench 上报告,相比 SkillRL 平均成功率提高 11.43 个百分点,平均执行时间下降;技能池扩到 1000 项时仍保留优势。结果来自指定基准,并非任何真实工作流都能自动提升同样幅度。
- 研究Google Research
Google 展示 Antigravity 多智能体科研协作
用并行智能体、验证器和人工审查推进科研与工程任务,并向学术研究人员开放申请。 Google Research 介绍 Antigravity 的 /teamwork 功能在科研与工程任务中的应用:由多个智能体并行尝试方案,再借助测试、验证器和人工审查筛选结果。 官方展示的任务覆盖数学、化学、Rust 重写与 TPU 优化。团队强调,研究人员仍负责提出问题、设定约束和核对输出;执行更多尝试本身不等于结果正确。
- 商业OpenAI
ChatGPT Wallet 开放授权购物,每笔交易需确认
首批面向美国成年 Pro 用户,绑卡后仍需逐笔确认,不是完全自主消费。 OpenAI 推出 ChatGPT Wallet,首批向美国 18 岁及以上的 Pro 用户开放,通过 dots 智能体完成购物。用户需要绑定符合条件的美国发行银行卡,并在每笔交易前确认商品、总价与支付卡。 付款通过 Face ID 或指纹等方式批准。系统使用卡组织令牌,智能体和商家不会获得真实卡号;符合条件的银行卡奖励与争议处理权利保留。
- 安全Cursor
Cursor 更新扩展安全事件调查,厘清攻击链
官方解释泄露凭证与恶意缓存扩展的关系,澄清该版本并非 Anthropic 发布。 Cursor 更新 10 月 29 日恶意扩展事件调查:攻击者利用泄露的 Fireworks 凭证访问部分旧智能体轨迹,继而从未完全脱敏的记录中获取凭证,并向 Cursor 缓存投放未经授权的 Claude Code 扩展。 Cursor 称,特定缓存构建在约 11 小时内可能触达最多 5000 名用户。这是潜在接收范围,不是确认 5000 台设备全部感染。恶意版本号为 2.1.312 与 2.1.313。
- 前沿X
DeepSeek 开放应用能力 API,接入搜索与文件处理
开发者可组合接入搜索、网页读取与文件能力,工具费用在模型 Token 费之外计算。 DeepSeek 11 月 13 日宣布开放更多应用能力 API,开发者可在模型调用中组合使用联网搜索、深度搜索、文件处理与网页读取等能力,覆盖 PDF、Office 文档和图片等输入。 官方公告列出 Messages、Responses 与 Chat Completions 接口的接入方式,并提供独立 Search、Fetch、OCR、ASR 和 TTS 等能力。
- 音频X
Haru-4B 开放权重,支持边听边说的语音对话
公开权重与多种推理实现,定位研究用基础模型,而非可靠的事实问答助手。 Higurashi 公开 Haru-4B 语音对话基础模型的权重与推理代码,采用 Apache 2.0 许可。它以全双工方式处理输入和输出,可以在听用户说话的同时生成语音,支持相互打断与接话。 项目提供 PyTorch Web 演示、面向 macOS 的 MLX 实现,以及 vLLM-Omni 服务插件。模型使用参考音频设定声音,但仓库不附带可直接挪用的声音素材。
- 开源GitHub
Cloudflare 开源 Kitesurf,浏览器引擎运行于 Workers
无需启动 Chrome 容器,通过 CDP 连接自动化客户端,仍是实验性引擎。 Cloudflare 开源实验性浏览器引擎 Kitesurf,可在 Workers 中解析 HTML、应用 CSS、执行页面 JavaScript 并渲染截图,无需启动 Chrome 或浏览器容器。 项目实现 Chrome DevTools Protocol,能连接 Puppeteer 等 CDP 客户端。官方定位包含智能体与浏览器自动化,但它是实验性引擎,不能直接当成完整 Chrome 的兼容替代品。
- 创业公司LangChain
LangChain 融资 3 亿美元,估值达 30 亿美元
CapitalG 领投 C 轮,公司继续发展智能体运行、改进与治理平台 LangSmith。 LangChain 宣布完成 3 亿美元 C 轮融资,投后估值 30 亿美元,由现有投资方 CapitalG 领投,GIC、DFJ Growth、IVP 与 Sapphire Ventures 等参与。 公司表示将继续发展 LangSmith,围绕智能体运行、评估改进与治理提供工具,支持企业选择模型并管理数据、基础设施、调用预算和工具权限。
- 安全Google
Project Zero 调整披露政策,逐步缩至 30 天
现在仍为 90 天,2027 年改为 60 天,计划 2028 年再缩至 30 天。 Google Project Zero 公布 Full X 漏洞披露政策,认为 AI 加快漏洞发现和补丁逆向速度,需要缩短修复与补丁分发的时间差。 新政策现阶段为 Full 90:从通知厂商起 90 天公开细节;计划在 2027 年 2 月 2 日改为 60 天,再于 2028 年 1 月 3 日改为 30 天。不是从本月起立即统一执行 30 天。