
Hugging Face 于 11 月 11 日发布 Token Pooling-Aware Training 教程,介绍如何让多向量检索模型适应压缩后的文档表示。
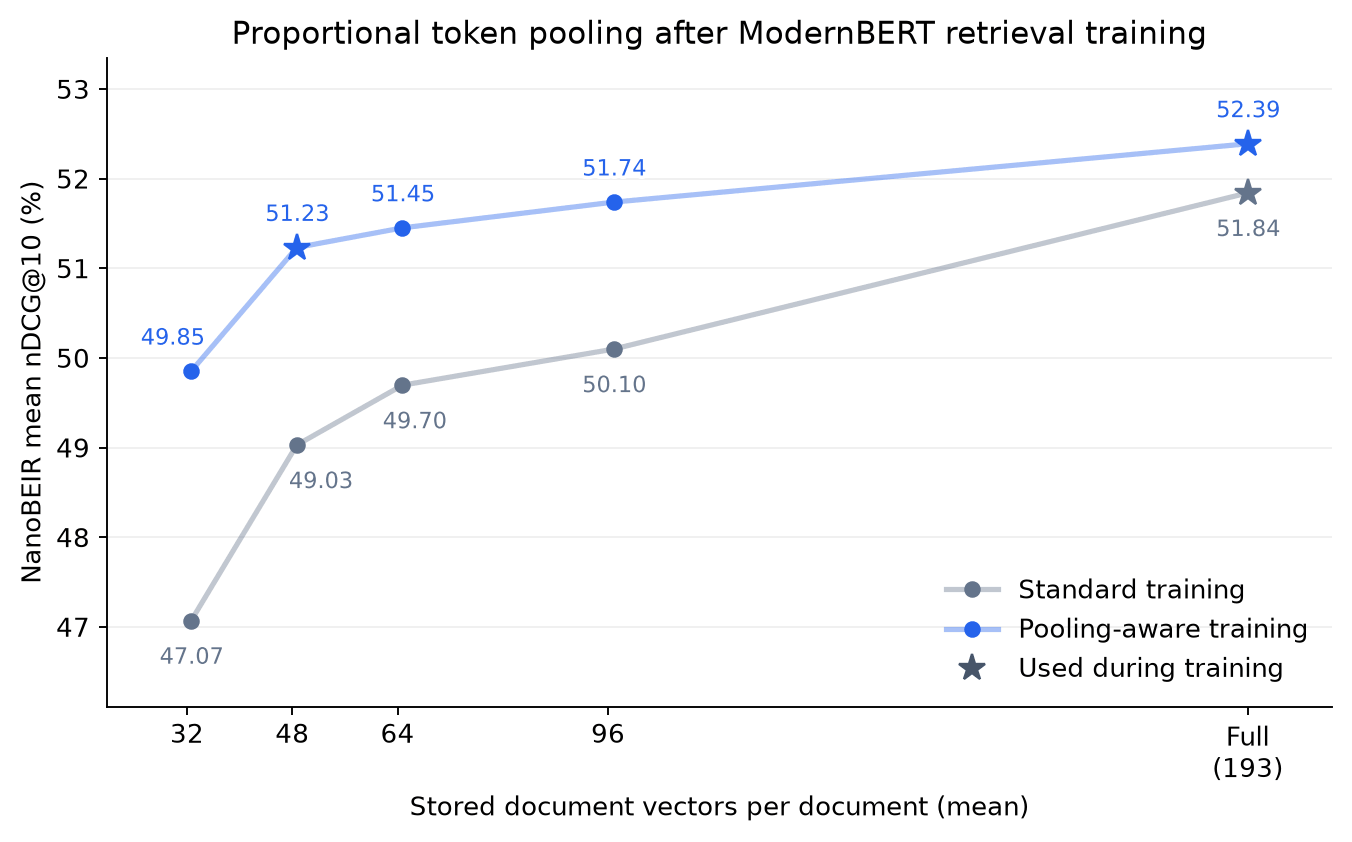
方法把相似的 Token 向量合并,同时在训练中加入压缩表示的检索目标。在作者的 NanoBEIR 实验里,文档向量减少至约四分之一时,普通训练保留原始检索分数的 94.6%,加入感知训练后提高至 97.8%。
文章提供 Sentence Transformers 复现示例,并说明压缩预算可以按文档长度或距离阈值调整。上述比例是相对未压缩分数的保留率,不是检索结果的绝对正确率。
来源:Hugging Face 原文。
图片来源:Hugging Face。