
11 月 16 日,Ruixi Yu 等研究者提交 ScaleVLA 技术报告,将 DeepSeek-V4.1-Flash-1017 的 5520 亿参数视觉语言骨干接入可训练的动作扩散 Transformer,用于连续机器人控制。系统读取相机画面和指令的特征,直接生成动作片段,不逐步生成文本推理。论文目前为预印本。
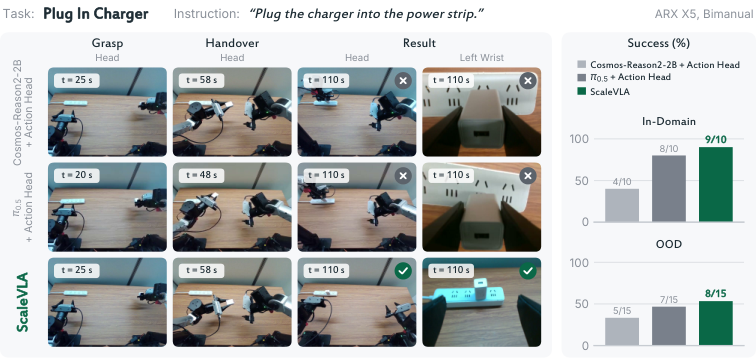
作者报告,在 LIBERO-Goal 中,每项任务使用 10 次演示时成功率为 87.8%;对照的 20 亿参数骨干使用 50 次演示时为 85.6%。在双臂机器人插充电器实验中,ScaleVLA 在接近训练布局的 10 次试验中成功 9 次,20 亿参数对照成功 4 次;改变充电器或插排位置后的 15 次试验中,分别成功 8 次和 5 次。
论文使用四张 H200 GPU,在 RoboCasa 上测得每个动作片段的推理中位延迟约 216 毫秒;真实机器人客户端测得的往返中位延迟为 384 毫秒。以上均为作者实验结果,尚不代表通用部署效果;变化布局下的精细插接仍有失败。
配图:Ruixi Yu 等,ScaleVLA 论文图 5,CC BY 4.0;原图未修改。
来源:arXiv · ScaleVLA 论文、ScaleVLA 项目页、DeepSeek · V4.1-Flash 官方说明。